概要
このガイドの内容
このガイドでは、VideoAnyの画像から画像への変換機能を使用して、元の写真を構造を維持しつつ創造的な変更を加えた新しい画像に変換する方法を詳しく説明します。異なるユースケースに対応する2つの異なるモデルについて解説し、「無修正」のアプローチが特定のクリエイティブな取り組みにとってなぜ重要であるかを説明します。
VideoAnyの画像から画像への変換ツールは、参照写真を新しい類似画像に変換します。元の構図、ポーズ、服装、照明を保持しつつ、新鮮なビジュアルを生成します。オプションで2枚目の参照写真と統合して顔を入れ替え、特定のキャラクターを新しいシーンに配置することも可能です。当社のプラットフォームは、入力と出力の間にコンテンツフィルターを介さずに動作します。
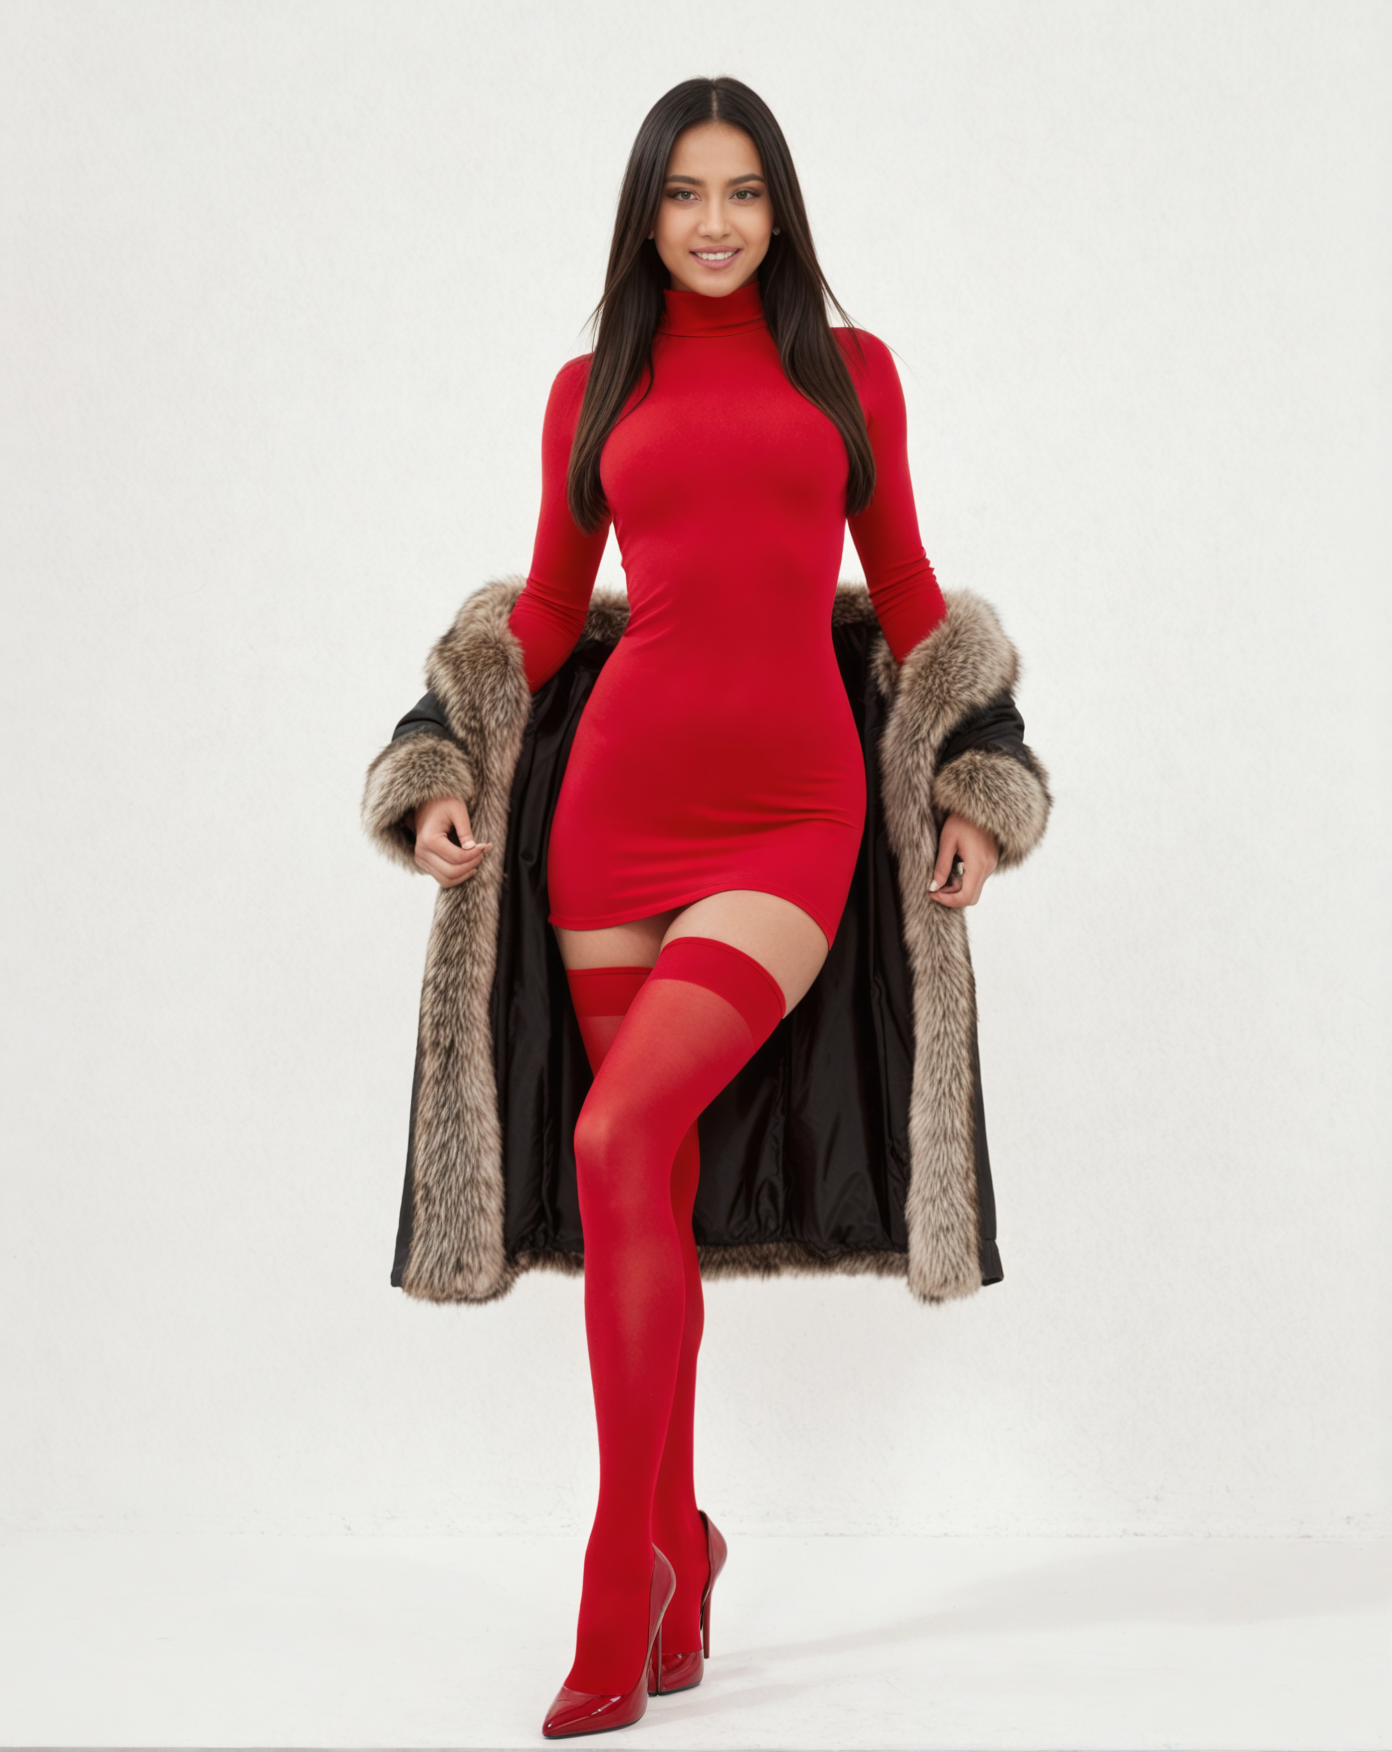
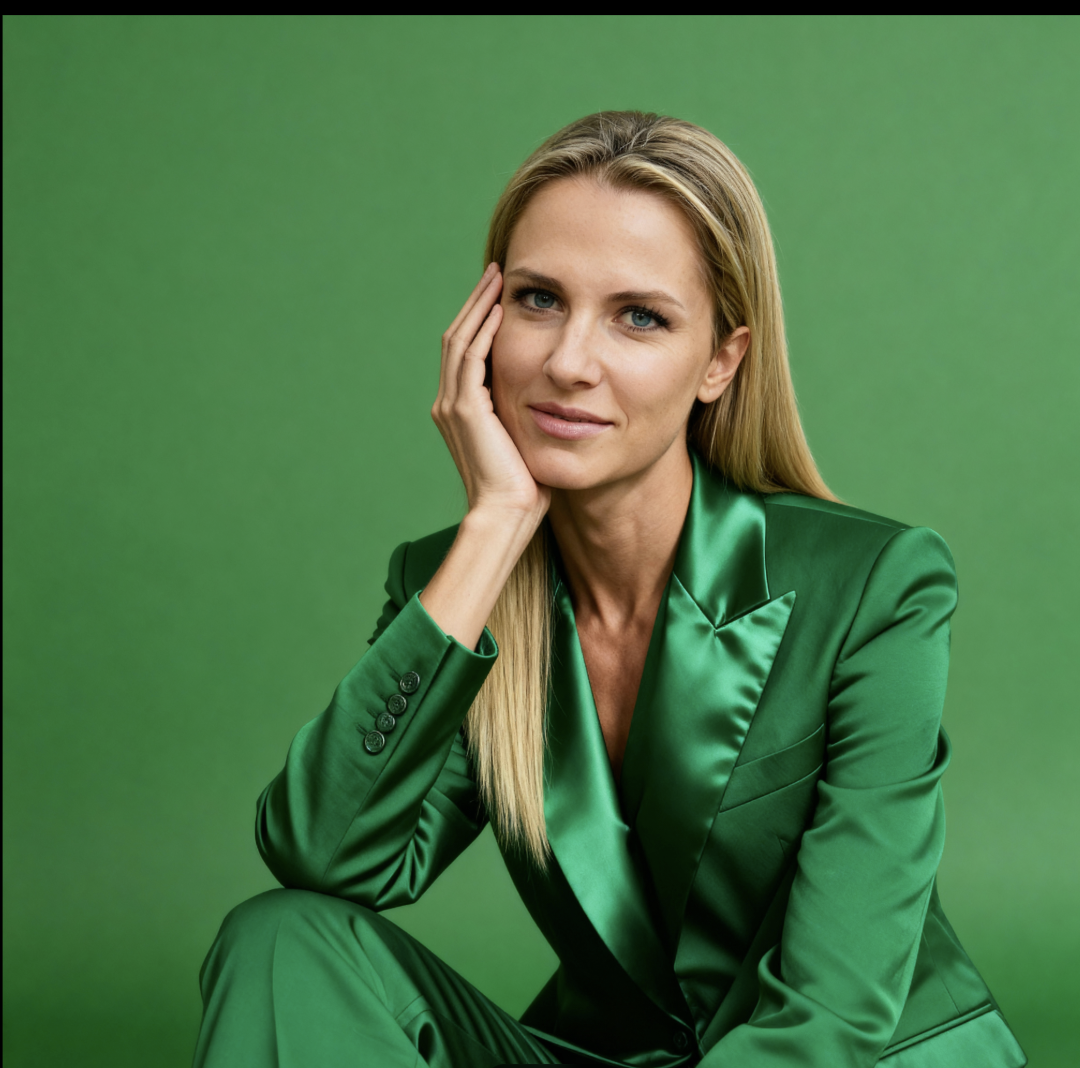
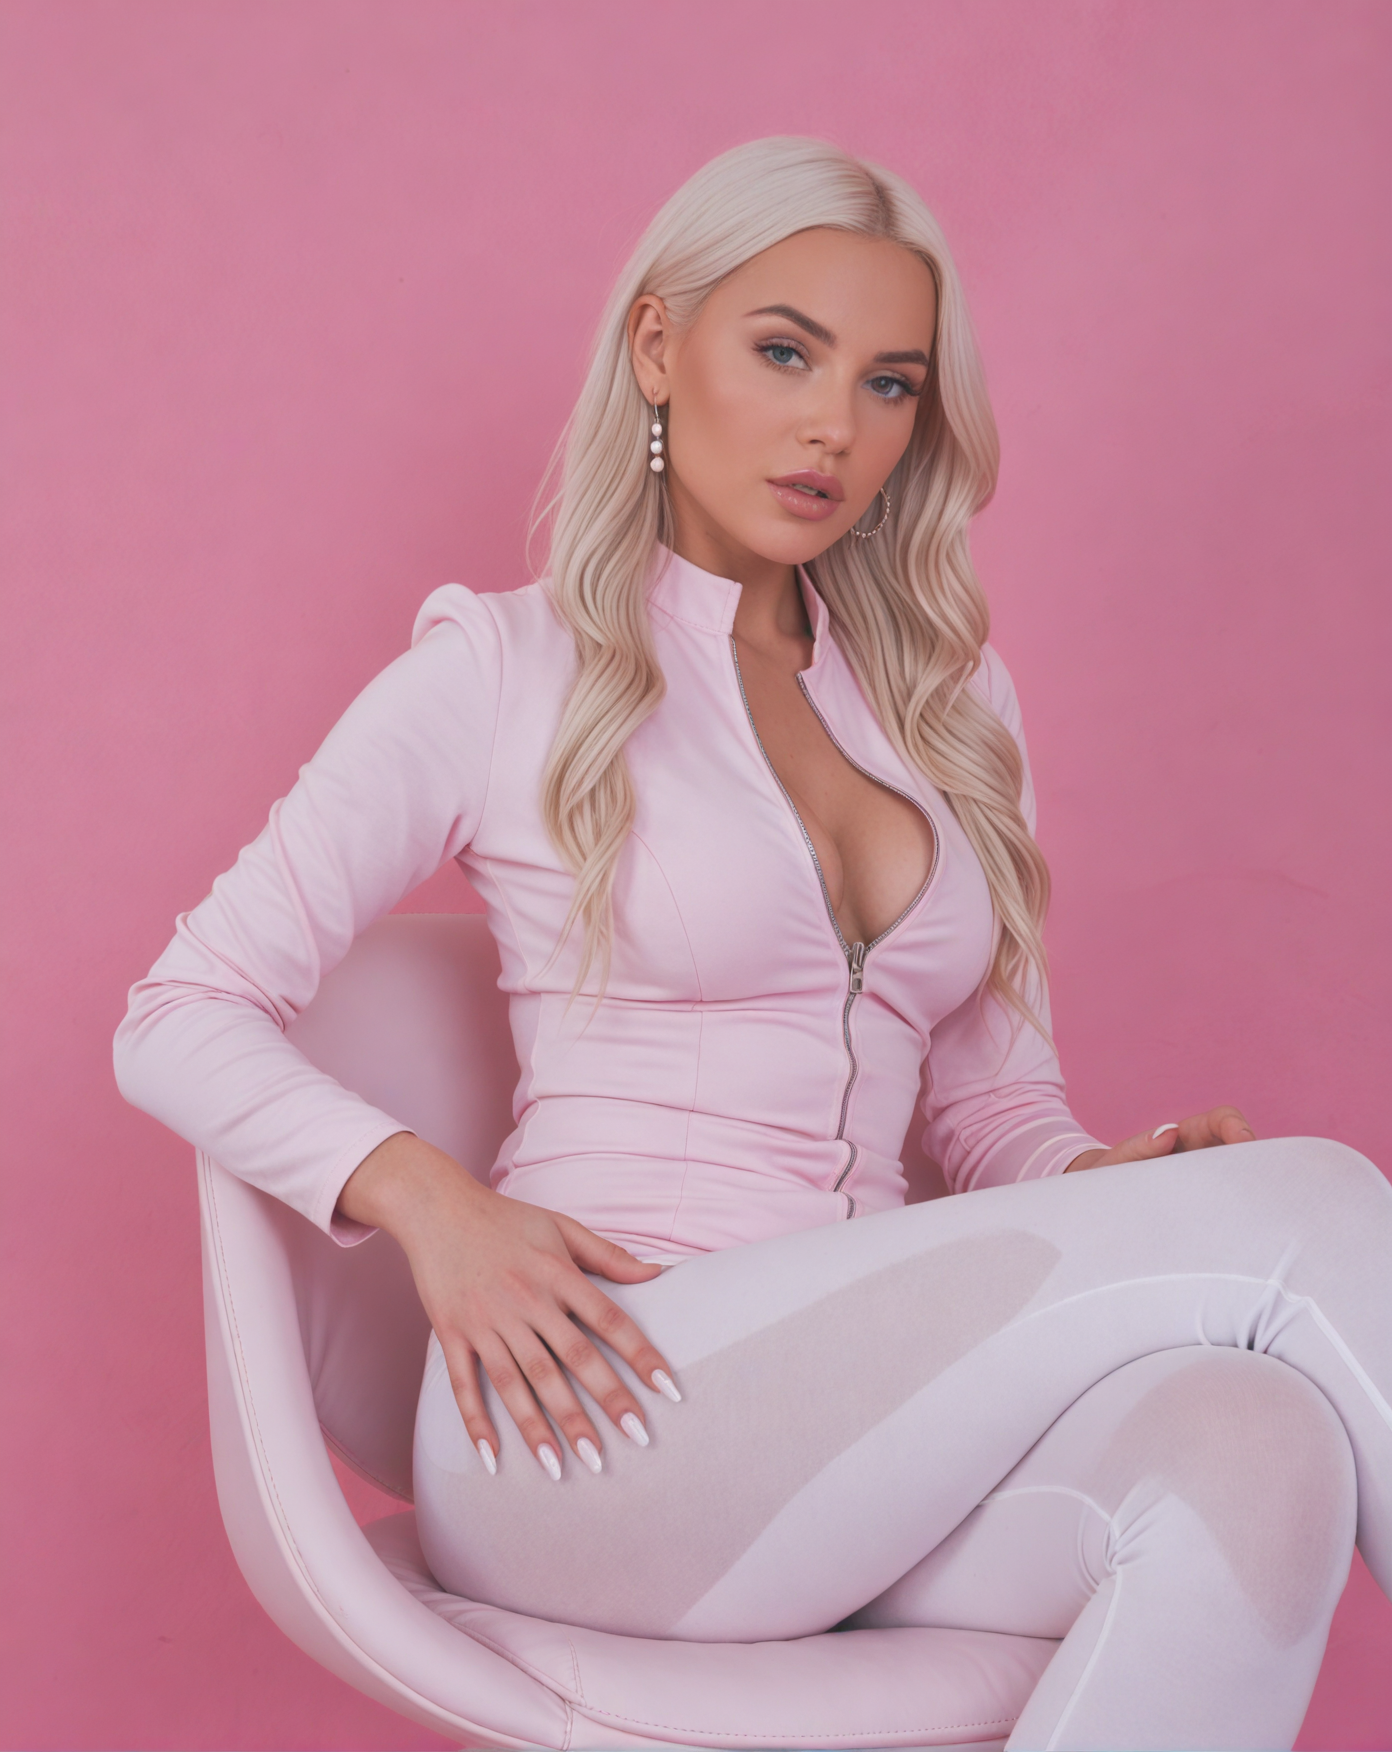
Image-to-Imageツールでは、主に「汎用(Seedream 4.5ベース)」と「SDXL」の2つのモデルを提供しています。汎用モデルは顔交換に対応しており、プロンプトによる部分的な影響も受けられるため、スタイル調整に幅広く活用できます。一方、SDXLはバリエーション生成に特化しており、顔交換には対応していません。また、プロンプトテキストはほとんど無視され、視覚的な参照にほぼ完全に依存します。このガイドに掲載されているすべての例は、Generalのツールから直接出力されたものです。
モデル選択の重要なポイントは、特定の顔が必要かどうかです。キャラクターの同一性が最優先される場合は、汎用モデルが最適です。新しい一般的な人物で問題ない場合は、SDXLを使用するとバリエーションをより迅速に生成できます。
主な機能の探求
- 構図とポーズを維持しながら、1枚の参照写真から新しい画像を生成します。
- 新しいシーンに特定のキャラクターを配置するための、2つ目の顔参照の統合。
- 汎用モデルとSDXLモデルの明確な動作を理解する。
- 画像から画像へのワークフローで効果的なプロンプトを作成する
このガイドは、実践的な応用とワークフローの最適化に焦点を当てています。
方法論
ツールの評価方法
Image-to-Imageツールの評価フレームワークでは、実用性と創造の自由度を最優先しています。各モデルが参照画像をどれだけ効果的に変換できるか、ユーザー入力への応答性、そして制限的なコンテンツフィルターを課すことなく多様なクリエイティブ要件に対応できる能力を評価します。
画像から画像へのジェネレーターを評価する際、私たちはクリエイターのワークフローに直接影響を与えるいくつかの主要な側面に焦点を当てています。参照画像から構図要素を正確に保持する能力は最も重要であり、新しいスタイルやキャラクターの詳細を導入する柔軟性も同様です。また、プロンプトの影響や、顔交換などの機能の有効性も綿密に調査します。
評価における重要な差別化要因は、コンテンツフィルターがないことです。多くのプラットフォームは、特にAIインフルエンサー生成や芸術表現といった分野において、正当なクリエイティブ作業を妨げる制限を課しています。VideoAnyの検閲されない環境へのコミットメントは、当社のツールが恣意的なコンテンツポリシーへの準拠ではなく、純粋な創造力に基づいて評価されることを意味します。
このセクションは、ソースページの証拠を反映しており、VideoAnyの実際のワークフローに合わせて調整されています。
評価項目
- 参照画像の構図、ポーズ、ライティングへの忠実性。
- 顔交換とキャラクターの一貫性の有効性
- スタイル制御のためのテキストプロンプトへの応答性。
- 画像生成の速度と効率性
ベンチマークは参考値であり、プロバイダーがモデルを更新するにつれて変動する可能性があります。
ランキングリスト
主要ツール
ここでは、主要な画像から画像への変換ツールを詳しく解説し、詳細なキャラクター統合から迅速なスタイルのバリエーションまで、さまざまなクリエイティブなニーズに対応するそれぞれの強みを強調します。
VideoAny汎用モデル(Seedream 4.5)
汎用モデルは、新しい構図で特定のキャラクターの顔を維持する必要がある場合に最適です。プロンプトを通じてスタイルの要素を強力に制御できます。AIインフルエンサーの作成や一貫性のあるビジュアルシリーズには、Generalの汎用モデルが最適です。
主な強み
- 一貫したキャラクターアイデンティティを保つための顔交換をサポートします。
- 参照元から構図、ポーズ、服装、照明を保持します。
- プロンプトにより、肌の色や照明などのスタイルの詳細を微調整できます。
- 顔と構図の参照を一度に融合させ、シームレスな結果を実現します。
- Pricing model
- VideoAnyの無料利用枠クレジットに含まれています。
- Trade-offs
- 単純なバリエーションではSDXLよりも遅くなる可能性があります。プロンプトの影響は部分的であり、絶対的ではありません。
- Best fit
- AIインフルエンサー作成、一貫したキャラクターシリーズ、詳細なスタイル調整。
VideoAny SDXLモデル
SDXLは、単一の参照画像から高速かつ類似したバリエーションを生成するのに優れています。異なる外観のA/Bテストや、シーンの複数のほぼ同一の複製を迅速に作成するのに最適ですが、プロンプト制御は最小限で、顔の交換機能はありません。
主な強み
- 参照画像から高忠実度なバリエーションを生成します。
- ポーズ、服装、顔の特徴が非常に似ています。
- 迅速な反復と多様な出力に対応する高速処理。
- 選択のために多数の類似コンテンツを生成するのに最適です。
- Pricing model
- VideoAnyの無料利用枠クレジットに含まれています。
- Trade-offs
- プロンプトテキストの影響は最小限です。顔交換機能はありません。一般的なものよりもスタイルの創造性は劣ります。
- Best fit
- ファッション/Eコマース向け衣装バリエーション、A/Bテスト、迅速なシーン複製。
一般(顔参照なし)
この汎用モデルのモードは、単一の参照写真を構図の設計図として使用し、その構造内に新しい人物を生成します。特定のキャラクターが重要ではない、さまざまなシーンに最適で、プロンプトが全体的な雰囲気を導きます。
主な強み
- 参照を構図とポーズの構造的ガイドとして扱います。
- シーンに合った新しいユニークな人物を生成します。
- プロンプトは、照明やムードなどのスタイルの詳細を効果的に調整します。
- 元のレイアウトを尊重しつつ、創造的な解釈を提供します。
- Pricing model
- VideoAny無料枠クレジットに含まれます。
- Trade-offs
- キャラクターの同一性を固定しません。目的のスタイルを得るには、慎重なプロンプト作成が必要です。
- Best fit
- 芸術的なバリエーション、編集コンテンツ、固定シーン内での多様なキャラクタータイプの探求。
VideoAny 顔交換ライブラリ
Image-to-Imageモデルそのものではありませんが、Face Swapライブラリは、汎用モデルを使用するクリエイターにとって不可欠なコンポーネントです。これにより、AIキャラクターの顔コレクションを構築・管理し、様々な構図で一貫して適用することができます。
主な強み
- 複数の画像間で一貫したキャラクターの同一性を実現します。
- 汎用画像生成モデルとシームレスに統合します。
- 保存された顔を新しい構図に適用するプロセスを簡素化します。
- AIインフルエンサーキャンペーンにおいて、ブランドアイデンティティを維持するために不可欠です。
- Pricing model
- VideoAnyフリーティアのクレジットに含まれています。
- Trade-offs
- 顔ライブラリ構築のための初期設定が必要です。
- Best fit
- AIインフルエンサー作成、ブランドの一貫性、キャラクター主導のコンテンツシリーズ。
VideoAny 写真撮影
PhotoShootは、初期構図の参考画像を生成する補助ツールです。適切な写真がない場合でも、PhotoShootは様々なテーマカテゴリで画像を生成し、それをImage-to-Imageパイプラインに供給できます。
主な強み
- ゼロから多様な構図リファレンスを生成します。
- 40種類以上のテーマ別カテゴリで、多様なシーンを演出。
- Image-to-Imageワークフローに直接フィードします。
- 「参照写真がまだありません」という問題を解決します。
- Pricing model
- VideoAnyの無料利用枠クレジットに含まれています。
- Trade-offs
- Image-to-Imageの前に別途ステップが必要です。
- Best fit
- カスタムリファレンス画像を必要とするクリエイターが、クリエイティブな選択肢を広げる。
VideoAny 画像から動画へ
このツールは、Image-to-Imageの出力画像を短いビデオクリップにアニメーション化し、ソーシャルメディアのリールやダイナミックなプレゼンテーションに最適です。生成された画像を動きのあるコンテンツへと活用範囲を広げます。
主な強み
- 静止画を魅力的な5~10秒の動画に変換します。
- ソーシャルメディアコンテンツやダイナミックなストーリーテリングに最適です。
- 画像から画像への生成に新たな次元を追加します。
- 生成された画像とのシームレスな連携。
- Pricing model
- VideoAnyの無料利用枠クレジットに含まれています。
- Trade-offs
- ショート動画に特化しており、本格的な動画編集ツールではありません。
- Best fit
- ソーシャルメディアマーケター、コンテンツクリエイター、AIアートに動きを加える。
VideoAnyアップスケーラー(顔保護モード)
アップスケーラー、特に顔保護モードは、Image-to-Image出力の品質向上に不可欠です。解像度を4Kに高めつつ、重要な顔のディテールを保持し、プロフェッショナル品質の結果を保証します。
主な強み
- 画像解像度を最大4Kまで向上させます。
- 顔の安全モードは、顔の特徴の歪みを防ぎます。
- 全体的なディテールと明瞭さを向上させます。
- 高品質な最終成果物には不可欠です。
- Pricing model
- VideoAnyの無料利用枠クレジットに含まれています。
- Trade-offs
- 初期生成には含まれない後処理ステップ。
- Best fit
- プロのアーティスト、写真家、高解像度の最終画像を必要とするすべての方。
VideoAny AI写真編集
AI画像編集ツールは、Image-to-Imageで生成された画像をさらに洗練させ、磨き上げるための機能を提供します。これにより、完璧な最終イメージを実現するための調整や強化が可能になります。
主な強み
- 後処理調整と機能強化を提供します。
- 生成された画像を微調整機能で補完します。
- 望み通りの美しさと品質を実現します。
- VideoAnyエコシステムに統合。
- Pricing model
- VideoAnyの無料利用枠クレジットに含まれています。
- Trade-offs
- 手動編集が必要です。自動生成ステップではありません。
- Best fit
- AI生成画像の微調整が必要なアーティスト、デザイナー、その他すべての方々
比較
比較表
この表は、VideoAnyのImage-to-Imageモデルと関連ツールについて、その主な機能、制御メカニズム、理想的な使用例を簡潔にまとめたものです。
| ツール/モデル | 主要機能 | 顔交換 | プロンプトの影響 | 最適な用途 | 開始価格 | 最適なソリューション |
|---|---|---|---|---|---|---|
| 汎用モデル(顔参照あり) | 構成 + 顔統合 | はい | 部分的(様式) | AIインフルエンサー、キャラクターの一貫性 | 未定 | ホスト型 |
| 汎用モデル(顔参照なし) | 構成のバリエーション | いいえ | 部分(様式) | 芸術的なバリエーション、シーンの探索 | 未定 | ホスト型 |
| SDXLモデル | 高精度バリエーション | いいえ | 最小限 | 迅速な反復、A/Bテスト | 未定 | ホスト型 |
| 顔交換ライブラリ | キャラクターの顔を管理 | N/A | N/A | 一貫したキャラクターアイデンティティ | 未定 | ホスト型 |
| PhotoShoot | 参照画像を生成 | N/A | 該当なし | カスタムコンポジションソース | 未定 | ホスト型 |
| 画像から動画へ | 画像アニメーション | N/A | N/A | ソーシャルメディアリール、ダイナミックコンテンツ | 未定 | ホスト型 |
| アップスケーラー (顔保護) | 解像度を向上させる | N/A | N/A | 高品質な最終成果物 | 未定 | ホスト型 |
| AI写真編集 | 洗練と磨き上げ | 該当なし | N/A | 生成後の調整 | 未定 | ホスト型 |
詳細なテストの前に、このマトリックスを使用して迅速なフィルタリングを行ってください。
意思決定フレームワーク
最適なオプションの選び方
適切な画像から画像へのモデルとワークフローの選択は、具体的なクリエイティブ目標に大きく依存します。このフレームワークは、キャラクターの一貫性、迅速なバリエーション、または芸術的な解釈のいずれを優先するかに基づいて、オプションをナビゲートするのに役立ちます。
VideoAnyのGeneralモデルとSDXLモデルのどちらを選択し、他のツールとどのように統合するかは、プロジェクトの要件によって決まります。それぞれの主要な強みを理解することで、効率的かつ効果的な画像生成が可能になります。
例えば、異なるポーズや衣装で一貫したAIキャラクターの画像をシリーズで作成することが目標であれば、顔参照付きの汎用モデルが不可欠です。単一のシーンのわずかに異なるバージョンを多数迅速に生成して選択する必要がある場合は、SDXLが断然優れています。重要なのは、ツールの機能を目的の成果と一致させることです。
このセクションは、ソースページの証拠を反映しており、VideoAnyの実際のワークフローに合わせて調整されています。
クイック選択ルール
- **一貫したキャラクター(AIインフルエンサー)の場合:**常に顔の参照を伴う汎用モデルを使用してください。まずキャラクターライブラリを構築してください。
- 特定の顔を含まない構図のバリエーションの場合:顔参照なしで汎用モデルを使用し、スタイルの指示にはプロンプトを活用してください。
- **シーンの迅速かつ高忠実度なバリエーションを作成する場合** SDXLモデルを選択してください。プロンプトは短くするか、完全に省略してください。
- 参照写真がない場合:VideoAnyのPhotoShootから始めて、適切な基本画像を生成します。
多くのクリエイターは、下書きと推敲に2つのツールを組み合わせて使用しています。
よくある質問
よくあるご質問
VideoAnyの画像生成機能に関するよくある質問集。費用、コンテンツポリシー、モデルの動作などについて。
VideoAnyの画像から画像への変換ツールは本当に無料ですか?
はい、画像から画像へのツールは無料プランでご利用いただけます。生成用のクレジットも含まれており、開始にクレジットカードは不要で、出力には透かしが入りません。
実在の人物の写真を参考資料として使用できますか?
法的には、写真の所有者であるか、同意を得ている場合は可能です。技術的には、ツールはアップロードされたすべての画像を処理します。しかし、ディープフェイク防止のため、プラットフォームレベルのポリシーとして、既知の公人の顔に一致する参照をブロックしています。これはコンテンツフィルターではありません。
SDXLの参照画像と結果がほとんど同じに見えるのはなぜですか?
これはSDXLが意図した通りに動作していることを示しています。SDXLは高忠実度のバリエーションのために設計されており、ソースに非常に忠実です。より創造的な解釈や大幅なスタイルの変更が必要な場合は、汎用モデルに切り替えるか、参照強度スライダーを下げてください。
プロンプトはSDXLで機能しますか?
ほとんど不可能です。SDXLは主にバリエーションモデルであり、参照画像を主要な指示として扱います。プロンプトは弱いヒントと見なされます。スタイル要素を強力にプロンプト制御する必要がある場合は、汎用モデルを使用してください。
NSFW/アダルトな画像から画像への変換は可能ですか?
はい、VideoAnyのプラットフォームはコンテンツフィルターなしで運営されており、他のプラットフォームでは拒否される可能性のある合法的な成人向けクリエイティブ作品も許可しています。唯一の制限は、著名な公人に対するものであり、これはコンテンツフィルターではなく、プラットフォームレベルのガードレールです。
結論
結論
VideoAnyの画像から画像への変換機能は、
Image-to-Imageの力は、コア要素を維持しながら既存のビジュアルを変革する能力にあります。VideoAnyは、異なるクリエイティブな目的に最適化された2つの異なるモデル(汎用モデルとSDXLモデル)を提供しています。汎用モデルは、特定のキャラクターを統合し、スタイリッシュなプロンプト制御を可能にすることに優れており、AIインフルエンサーの作成や一貫性を必要とする芸術的なプロジェクトに最適です。一方、SDXLは速度と高忠実度のバリエーションのために構築されており、単一のソースから多数のオプションを迅速に生成するのに最適です。
VideoAnyの検閲されない環境は、クリエイティブな自由が恣意的なコンテンツフィルターによって制限されないことを保証し、より幅広い芸術的および商業的アプリケーションを可能にします。画像から画像への変換を、顔認識、写真撮影、アップスケーラーなどの他のツールと組み合わせることで、包括的で効率的なクリエイティブパイプラインを構築できます。
このセクションは、ソースページの証拠を反映しており、VideoAnyの実際のワークフローに合わせて調整されています。
Image-to-Imageの主なポイント
- **一般モデル(顔参照あり):** 一貫したキャラクターの同一性とAIインフルエンサーのワークフローに最適な選択肢です。
- **汎用モデル(顔参照なし):** スタイルのバリエーションや、固定された構図内で様々なキャラクターを探索するのに最適です。
- **SDXLモデル:** 高速で類似したバリエーションを生成し、異なるデザインのA/Bテストを行うのに最適です。
- **検閲なしのプラットフォーム:** 成人向けコンテンツやAIインフルエンサーの作品を含む、すべての合法的なコンテンツにおいて創造の自由を可能にします。
モデルのパフォーマンスやポリシーは変更されるため、定期的に再テストしてください。
次のステップ
VideoAnyで検閲されないワークフローを構築しましょう
VideoAnyの画像・動画パイプラインで、比較から実行へと移行しましょう。
- 実用的なワークフローを素早く開始
- テキスト、画像、動画の出力を組み合わせる
- 無料テストから有料本番環境までスケールアップ