概要
Flux Klein + Flux Klein + LoRAを選ぶ理由
VideoAnyのFlux Klein + LoRAは、カスタマイズ可能なLoRAスタッキング機能により、唯一無二の存在です。ユーザーは、多様な体型、芸術スタイル、キャラクターテンプレートのライブラリから選択し、画像生成ごとに最大3つの異なるLoRAを適用できます。
Flux Klein + LoRAは、VideoAnyで唯一、プラットフォームの広範なライブラリからLoRAスタイルを組み合わせることを可能にするモデルです。これには、様々な体型(ボンブシェル、カーヴィー、スリム、筋肉質、アワーグラスなど)、多様なアートスタイル、特定のキャラクターテンプレートが含まれます。各生成において最大3つのLoRAを同時に重ねることができ、それぞれ独立した強度制御が可能です。
このワークフローは、LoRAの選択と組み合わせて1~3枚の参照画像をサポートします。この機能は、選択したLoRAレイヤーをユーザー自身の写真に適用する際に特に役立ち、正確なスタイル転送を可能にします。モデルは検閲なしで動作し、画像編集とImage Editor内でのスタイル化された写真撮影の両方に利用できます。
Flux Klein + LoRAは、VideoAnyで唯一、プラットフォームの豊富なライブラリからLoRAスタイルを選択し、重ね合わせることができるモデルです。これには、体型、アートスタイル、キャラクターテンプレートのオプションが含まれます。1回の生成につき最大3つのLoRAレイヤーを重ねることができ、それぞれ強度を調整可能です。
主な考慮事項
- このモデルは画像エディター専用であり、テキストから画像への生成には対応していません。プロンプトのみのLoRAスタッキングには、SDXLをご検討ください。
- 利用可能なLoRAライブラリが要件を満たさない場合、このバリアントは、固定スタイルを含むデフォルトのFlux Kleinと比較して、パフォーマンスが低下する可能性があります。
- 出力解像度は1メガピクセルに制限されています。より高解像度が必要な場合は、SDXL(最大4K)やSeedream 5(2K)などの代替手段をご利用いただけます。
- Flux Klein + LoRAへのアクセスは、信頼できるユーザーアカウントに限定されています。
これを実用的なチェックポイントとして活用してください。ワークフローを拡張する前に、同じプロンプトで出力を比較してください。
モデル適合
Flux Klein + LoRAのパフォーマンスを理解する
この比較は、このワークフローが最適な場合と、他のVideoAnyモデルがより適している場合を判断するのに役立ちます。
| 意思決定領域 | 重要性 | 実用的なシグナル | VideoAnyアクション |
|---|---|---|---|
| Flux Klein + Flux Klein + LoRAを選ぶ理由 | ソースガイドからの主要な教訓 | Flux Klein + LoRAは、VideoAnyで唯一、プラットフォームの豊富なライブラリからLoRAスタイルを選択し、重ね合わせることができるモデルです。これには、体型、アートスタイル、キャラクターテンプレートのオプションが含まれます。生成ごとに最大3つのLoRAレイヤーを重ねることができ、それぞれに調整可能な強度を設定できます。 | プロジェクトにおいて、正確なスタイルの階層化が不可欠な場合に活用してください。 |
| Flux Klein + LoRAとは? | ソースガイドからの主要な教訓 | このワークフローは、LoRAの選択と合わせて1~3枚の参照画像をサポートしています。この機能は、選択したLoRAレイヤーをユーザー自身の写真に適用する際に特に役立ち、正確なスタイル転送を可能にします。このモデルは検閲なしで動作し、画像編集とImage Editor内でのスタイル化された写真撮影の両方に利用できます。 | 参照画像とカスタムLoRAアプリケーションの組み合わせが重要な場合に活用します。 |
| Flux Klein + Flux Klein + LoRAの動作をご覧ください | ソースガイドからの主要な教訓 | Flux Klein + LoRAは、VideoAnyで唯一、プラットフォームの広範なライブラリからLoRAスタイルを組み合わせることを可能にするモデルです。これには、様々な体型(ボンブシェル、カーヴィー、スリム、筋肉質、アワーグラスなど)、多様なアートスタイル、特定のキャラクターテンプレートが含まれます。各生成において最大3つのLoRAを同時に重ねることができ、それぞれ独立した強度制御が可能です。 | 美的属性と文字属性をきめ細かく制御するために活用します。 |
| Flux Klein + LoRAと他のVideoAnyモデルの比較 | ソースガイドからの主要な教訓 | ただし、いくつかの制限があります。このバリアントは画像エディター専用であり、テキストから画像への生成には利用できません。解像度は標準のFlux Kleinと同様に1MPに制限されています。重要なのは、その効果がLoRAの選択の質と関連性に大きく依存することです。最適でない選択は、統合されたKlein-Unchained-V2スタイルを持つデフォルトのFlux Klein NSFWモデルよりも劣る結果につながる可能性があります。このモデルへのアクセスは、信頼できるユーザーのみに許可されています。 | テキストから画像への変換、高解像度、または固定スタイルをご希望の場合は、Flux Klein + LoRA以外の代替案をご検討ください。 |
複数の目標を単一のプロンプトに混ぜるのではなく、一度に1つの視覚的ジョブをテストすることで、最も強力な結果が得られます。
ワークフロー
Flux + LoRAの運用
ソースガイドの推奨事項を反復可能なVideoAny出力に変換するための実践的なシーケンス。
ただし、いくつかの制限があることに注意が必要です。このバリアントは画像エディター専用であり、テキストから画像への生成には利用できません。解像度は標準のFlux Kleinと同様に1MPに制限されています。重要なのは、その有効性がLoRAの選択の品質と関連性に大きく依存していることです。最適な選択をしないと、統合されたKlein-Unchained-V2スタイルを持つデフォルトのFlux Klein NSFWモデルよりも劣る結果になる可能性があります。このモデルへのアクセスは、信頼できるユーザーのみに許可されています。
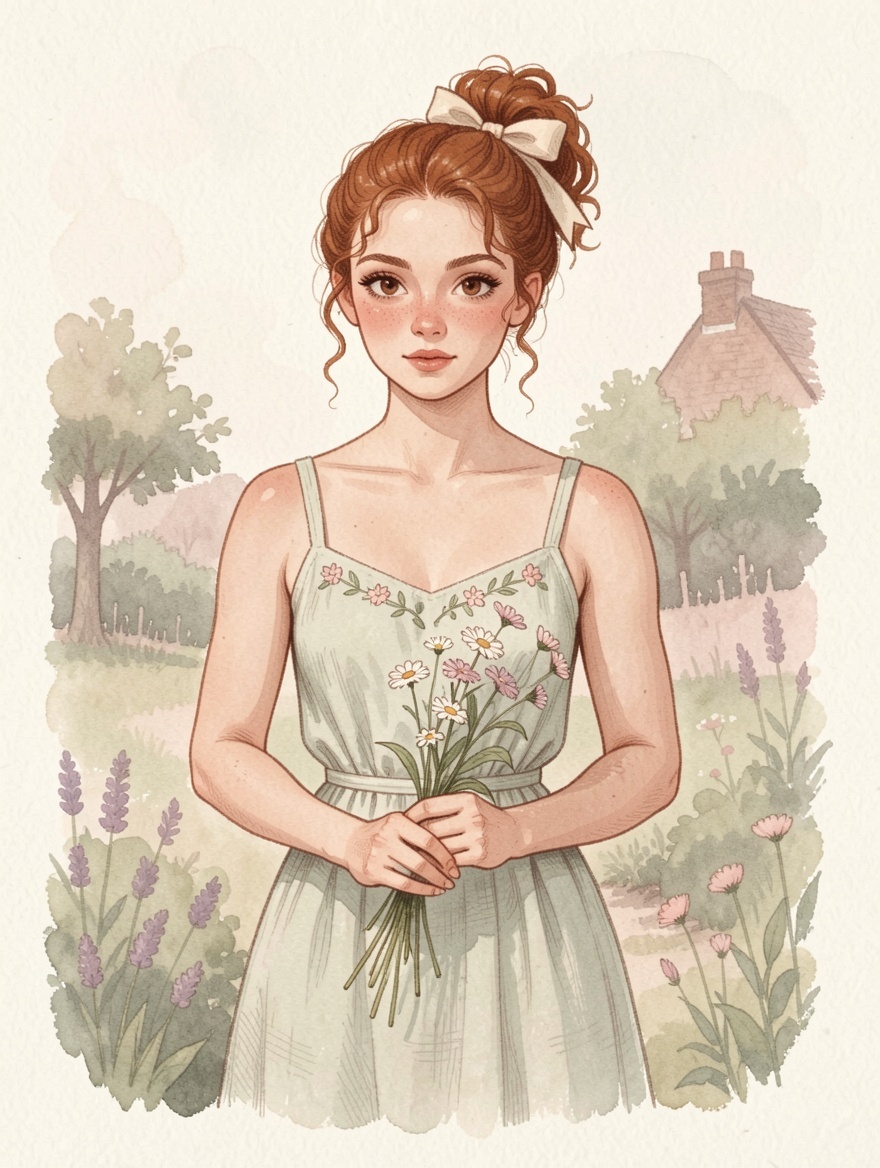
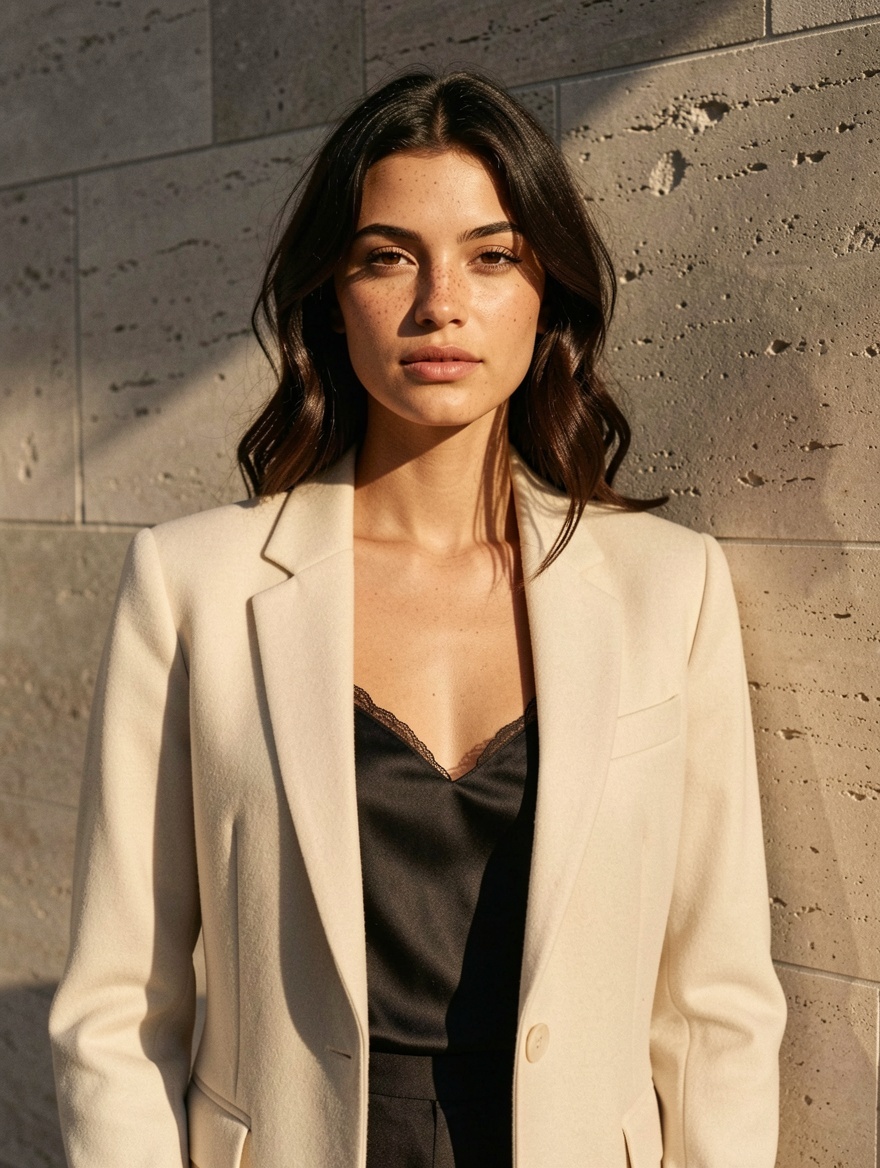
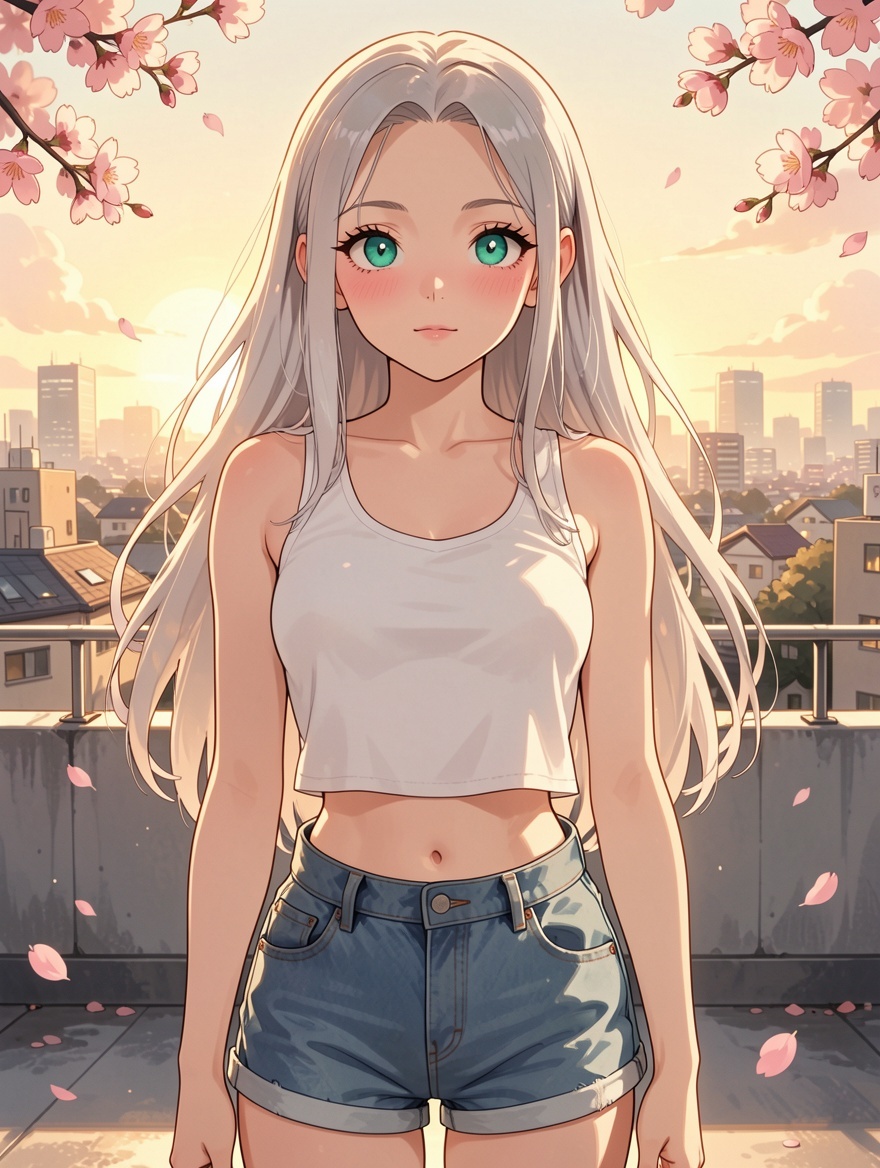
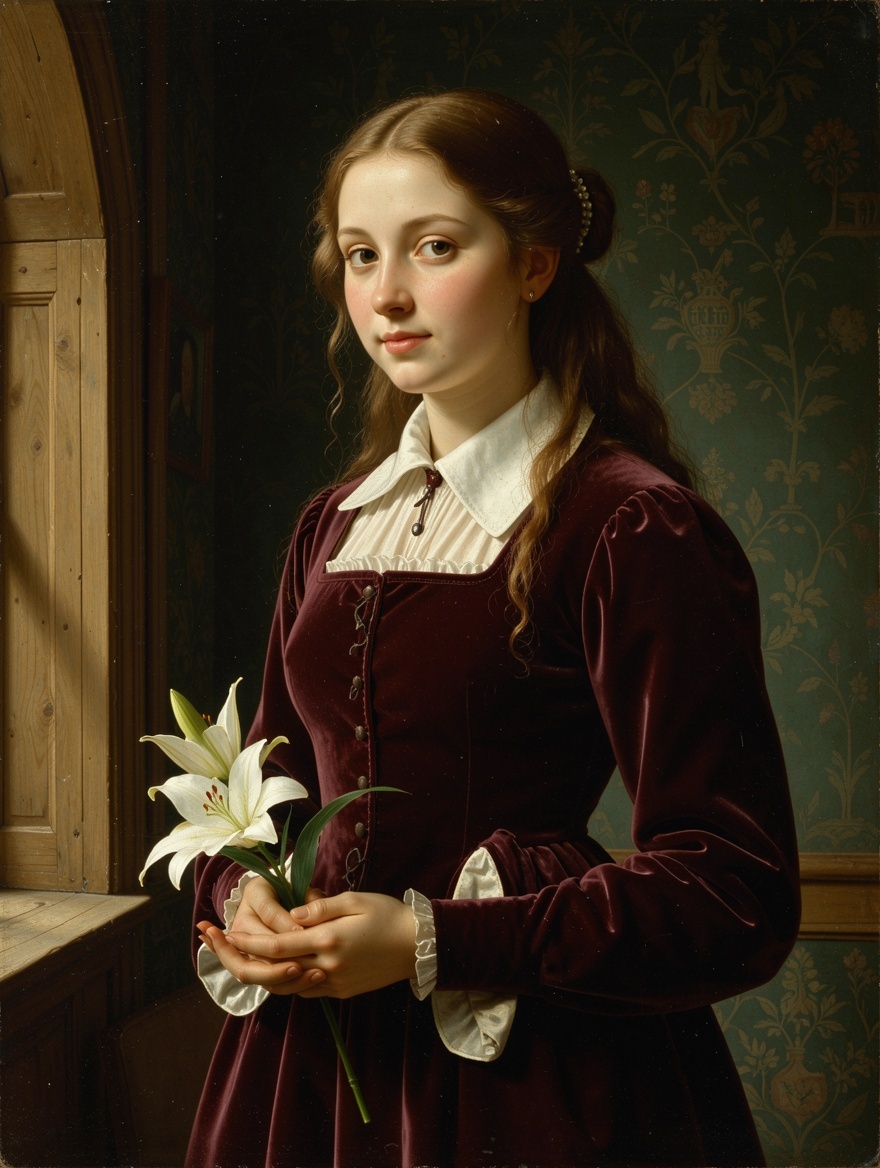
このサービスでは6つのプロンプトと生成結果を掲載し、LoRAライブラリの表現幅を示しています。プロンプトをコピーし、エディターで適切なLoRAを選べば、同じ条件から制作を始められます。
代替モデルがより適している主なシナリオは3つあります。
LoRAスタックワークフローを最適化するための洗練された5つの戦略をご紹介します。
本番環境チェックリスト
- アカウントがモデルへの信頼できるアクセス権を持っていることを確認してください。
- 画像エディターを開き、参照画像を1~3枚アップロードしてください。
- モデルオプションからFlux Klein + LoRAを選択します。最大3つのLoRA(例:体型、アートスタイル、キャラクター)を選択し、それぞれの強度を調整します。
- 選択したLoRAに合わせたプロンプトを作成します。生成を開始します。
短く具体的なプロンプトは、漠然としたクリエイティブブリーフよりも比較しやすいです。
ユースケース
Flux Klein + LoRAと他のVideoAnyモデルの比較
これらの例は、VideoAnyの具体的な制作パターンへと応用できます。
Flux Klein + LoRA — Advanced LoRA Image Editing on VideoAny source gallery visual 1
Flux Klein + LoRA画像エディターのみである理由
このバリアントは画像エディター専用であり、テキストから画像生成には利用できません。解像度は標準のFlux Kleinと同様に1MPに制限されています。重要な点として、その効果は選択するLoRAの品質と関連性に大きく依存します。最適な選択をしないと、統合されたKlein-Unchained-V2スタイルを持つデフォルトのFlux Klein NSFWモデルよりも劣る結果になる可能性があります。このモデルへのアクセスは、信頼できるユーザーのみに許可されています。
視聴コンテンツ
- モデルの選択を正確な視覚的ジョブに合わせる。
- プロンプトの意図は、短く、具体的で、テスト可能に保つ。
- 拡大する前に、身元、照明、解剖学的構造、およびテキストを確認してください。
- 最初のパスで動きや編集が必要な場合は、VideoAnyのフォローアップツールをご利用ください。
- Pricing model
- VideoAnyの標準クレジットは、選択されたモデルと出力設定によって異なります。
- Trade-offs
- 出力品質は、プロンプトの明確さ、ソース画像の品質、および反復予算に依然として依存します。
- Best fit
- アセットごとにワークフローを再構築することなく、再現性のあるAIビジュアルを必要とするクリエイター向け。
Flux Klein + LoRA — Advanced LoRA Image Editing on VideoAny source gallery visual 2
ベース版Flux Kleinとの違いは?
このサービスでは6つのプロンプトと生成結果を掲載し、LoRAライブラリの表現幅を示しています。プロンプトをコピーし、エディターで適切なLoRAを選べば、同じ条件から制作を始められます。
視聴コンテンツ
- モデルの選択を正確な視覚的ジョブに合わせます。
- プロンプトの意図は、短く、具体的で、テスト可能に保つ。
- 拡大する前に、身元、照明、解剖学的構造、およびテキストを確認してください。
- 最初のパスで動きや編集が必要な場合は、VideoAnyのフォローアップツールをご利用ください。
- Pricing model
- VideoAnyの標準クレジットは、選択されたモデルと出力設定によって異なります。
- Trade-offs
- 出力品質は、プロンプトの明確さ、ソース画像の品質、および反復予算に依然として依存します。
- Best fit
- アセットごとにワークフローを再構築することなく、反復可能なAIビジュアルを必要とするクリエイター向け。
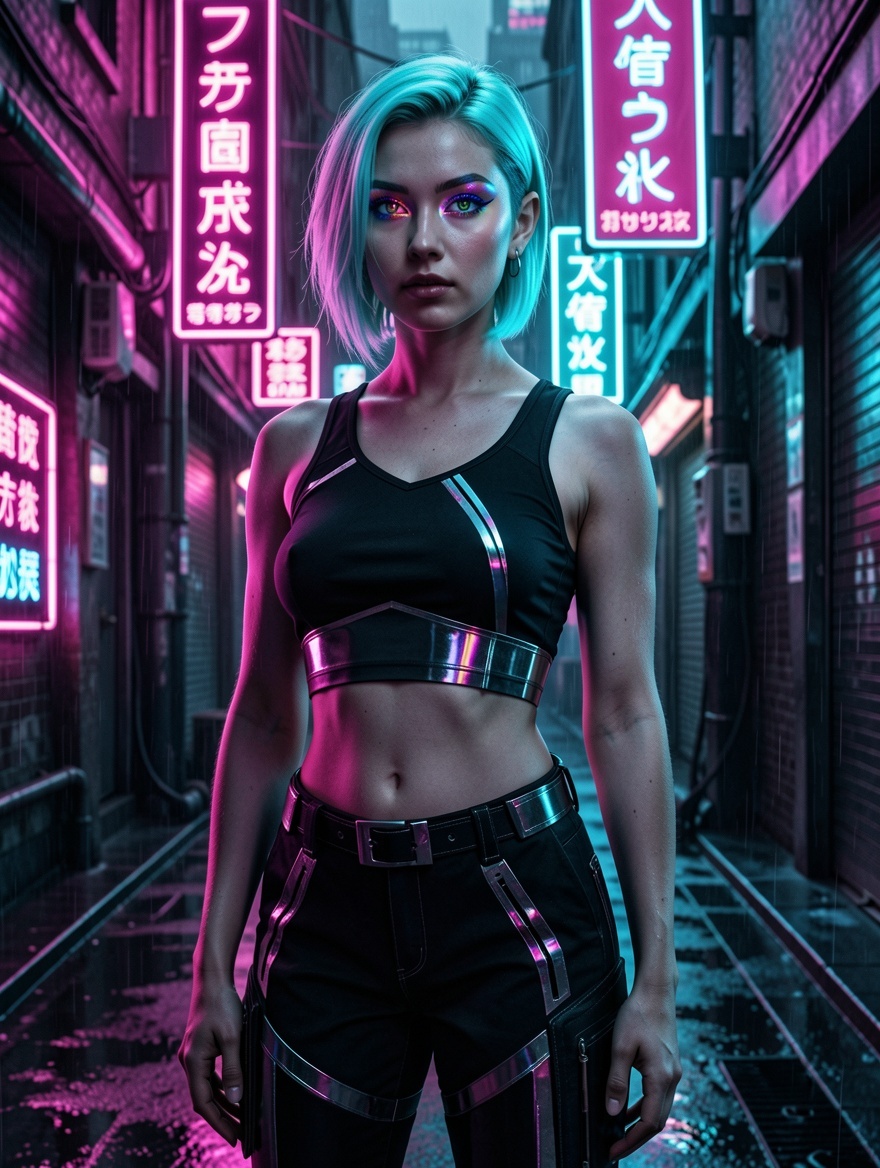
Flux Klein + LoRA — Advanced LoRA Image Editing on VideoAny source gallery visual 3
SDXLとの違いは何ですか?
代替モデルがより適している主なシナリオは3つあります。
視聴コンテンツ
- モデルの選択を正確なビジュアルジョブに合わせる。
- プロンプトの意図は、短く、具体的で、テスト可能に保つ。
- 拡大する前に、身元、照明、解剖学的構造、およびテキストを確認してください。
- 最初のパスで動きや編集が必要な場合は、VideoAnyのフォローアップツールをご利用ください。
- Pricing model
- VideoAnyの標準クレジットは、選択されたモデルと出力設定によって異なります。
- Trade-offs
- 出力品質は、プロンプトの明確さ、ソース画像の品質、および反復予算に依然として依存します。
- Best fit
- アセットごとにワークフローを再構築することなく、反復可能なAIビジュアルを必要とするクリエイター向け。
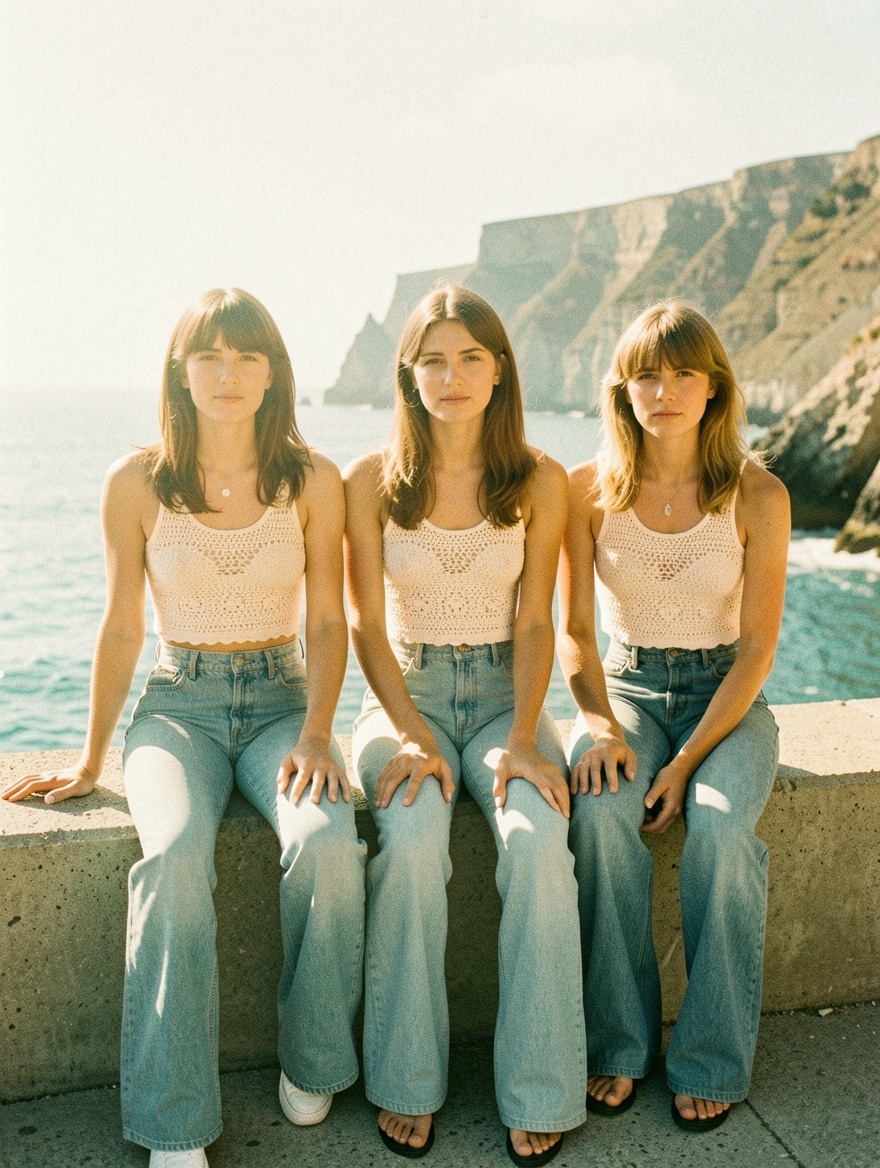
Flux Klein + LoRA — Advanced LoRA Image Editing on VideoAny source gallery visual 4
いくつのLoRAを重ねて適用できますか?
LoRAスタックワークフローを最適化するための5つの洗練された戦略を以下に示します。
視聴コンテンツ
- モデルの選択を正確なビジュアルジョブに合わせます。
- プロンプトの意図は、短く、具体的で、テスト可能に保つ。
- 拡大する前に、身元、照明、解剖学的構造、およびテキストを確認してください。
- 最初のパスで動きや編集が必要な場合は、VideoAnyのフォローアップツールをご利用ください。
- Pricing model
- VideoAnyの標準クレジットは、選択されたモデルと出力設定によって異なります。
- Trade-offs
- 出力品質は、プロンプトの明確さ、ソース画像の品質、および反復予算に依然として依存します。
- Best fit
- アセットごとにワークフローを再構築することなく、反復可能なAIビジュアルを必要とするクリエイター向け。
よくある質問
このワークフローに関するよくある質問
Flux Klein + LoRAが画像エディターに限定されるのはなぜですか?
このバリアントは画像編集のために特別に開発され、Image Editorでシームレスにサポートされる機能であるLoRAスタックと並行して1~3枚の参照画像を統合します。純粋なテキストから画像へのLoRAスタッキングには、参照を必要とせずに3つのLoRAも処理できるため、(SDXL)がより良い選択肢です。
これは標準的なFlux Kleinとどう違うのですか?
ベースとなるFlux Kleinモデルは、デフォルトでKlein-Unchained-V2 LoRAを組み込んでおり、ユーザーがスタイルを選択することはできません。しかし、このバリアントでは、VideoAnyの完全なLoRAライブラリにアクセスでき、生成ごとに体型、アートスタイル、またはキャラクターテンプレートを選択し、独立した強度制御で最大3つのLoRAを重ねて適用できます。
とSDXLの違いは何ですか?
SDXLもLoRAスタッキングに対応していますが、2023年時点のStable Diffusion XLアーキテクチャに基づいています。一方、新しいFlux基盤上に構築されたFlux Kleinは、より優れたプロンプト理解、同等のLoRA強度でのより正確な解剖学的表現、そして現代的なFluxの美学を提供します。SDXLの利点としては、より高い最大解像度(最大4Kダイナミック vs. 1 MP)と、テキストから画像へのワークフローでの利用可能性が挙げられます。
Flux Klein + LoRAで重ねられるLoRAの最大数はいくつですか?
生成ごとに最大3つのLoRAをスタックでき、個々の強度は0.5から3.0の範囲で設定可能です。効果的な組み合わせとしては、ボディタイプLoRA、アートスタイルLoRA、キャラクターLoRAをそれぞれ1つずつ使用することが多いです。3つ以上のLoRAをスタックすると、モデルの混乱を招き、出力品質が低下する可能性があります。
必要なLoRAライブラリが見つからない場合はどうすればよいですか?
適切なLoRAが利用できない場合、このバリアントは常にKlein-Unchained-V2スタイルを適用する標準のFlux Kleinよりも効果が低下します。そのような場合は、不適切なLoRAを選択すると出力が悪化する可能性があるため、任意のLoRAを選択するよりもベースモデルを使用することをお勧めします。
このモデルで参照画像を使用できますか?
はい、生成ごとに1~3枚の参照画像を使用できます。最適な結果を得るために、プロンプト内で各参照を明示的にラベル付けしてください(例:「顔の参照1」、「服装スタイルの参照2」)。これにより、モデルは視覚情報を対応する出力領域に正確にルーティングできます。
作成
VideoAnyで高度なLoRA画像編集ワークフローを構築
このモデルガイドを基盤として活用し、統合されたVideoAnyワークフロー内で、生成、編集、アニメーション化、公開をシームレスに行いましょう。
- 明確なプロンプトから画像を生成する
- 魅力的な静止画をダイナミックな動画に変換する
- バッチ処理設定の一貫性を維持