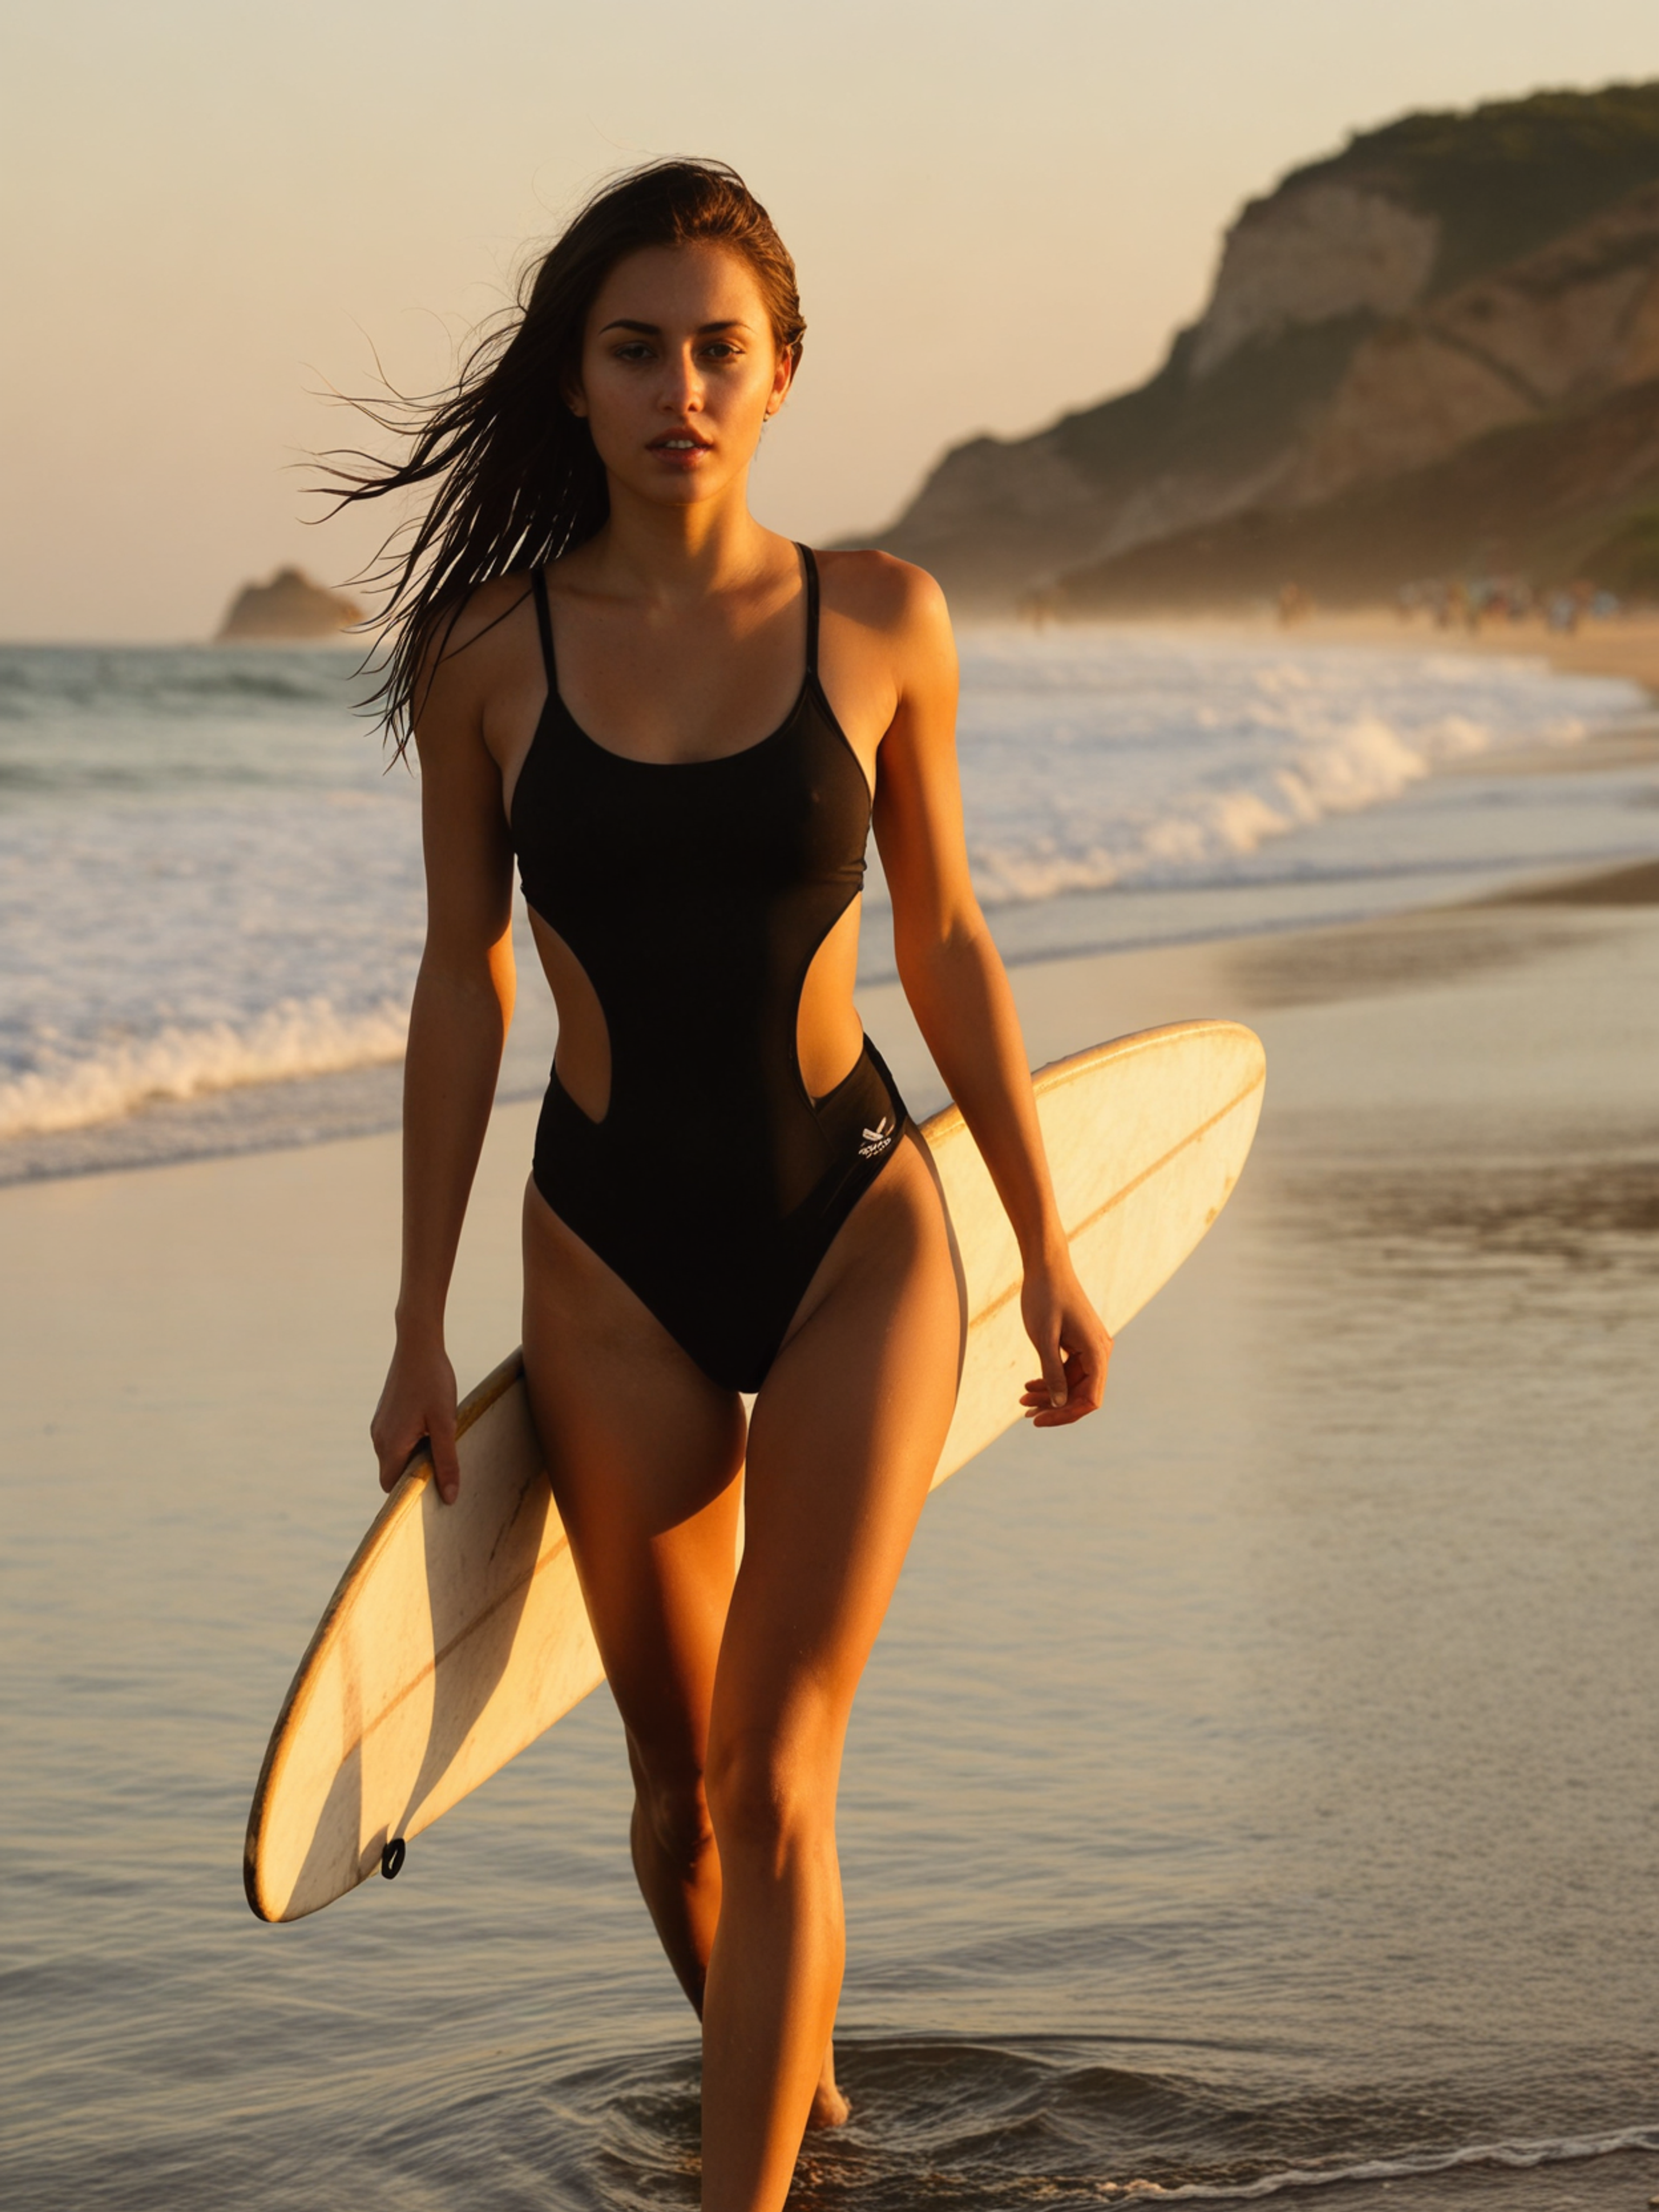
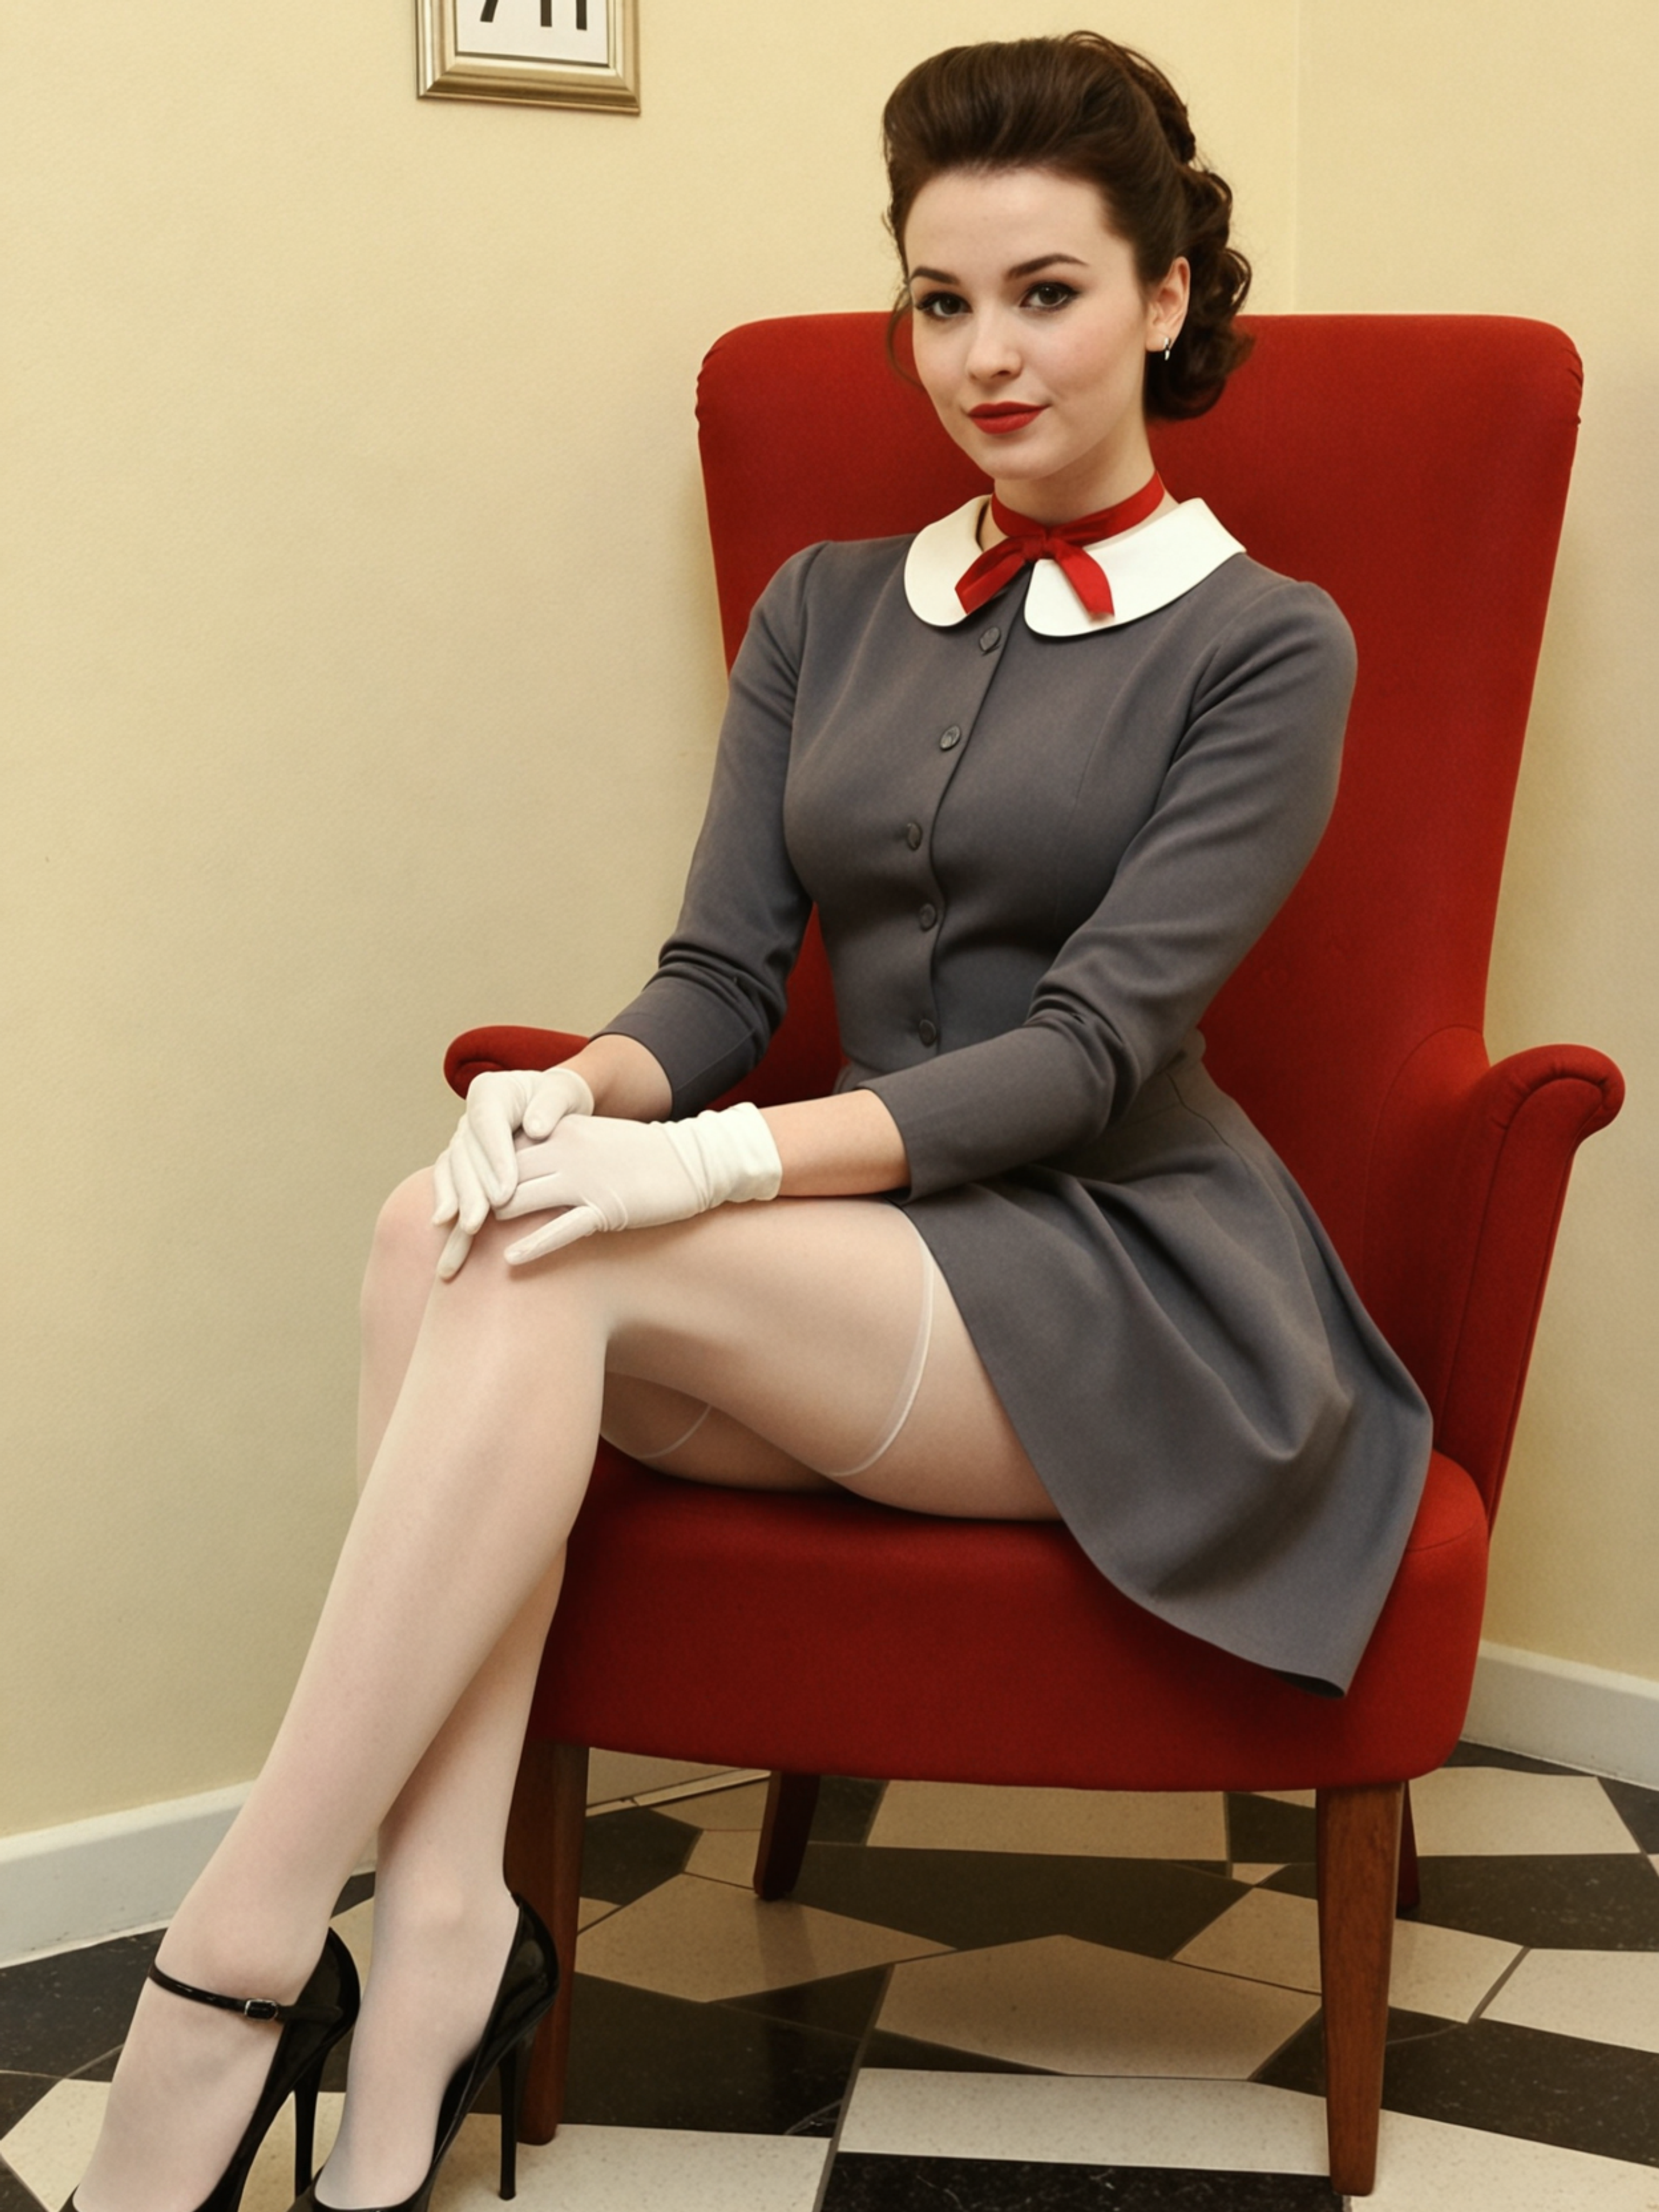
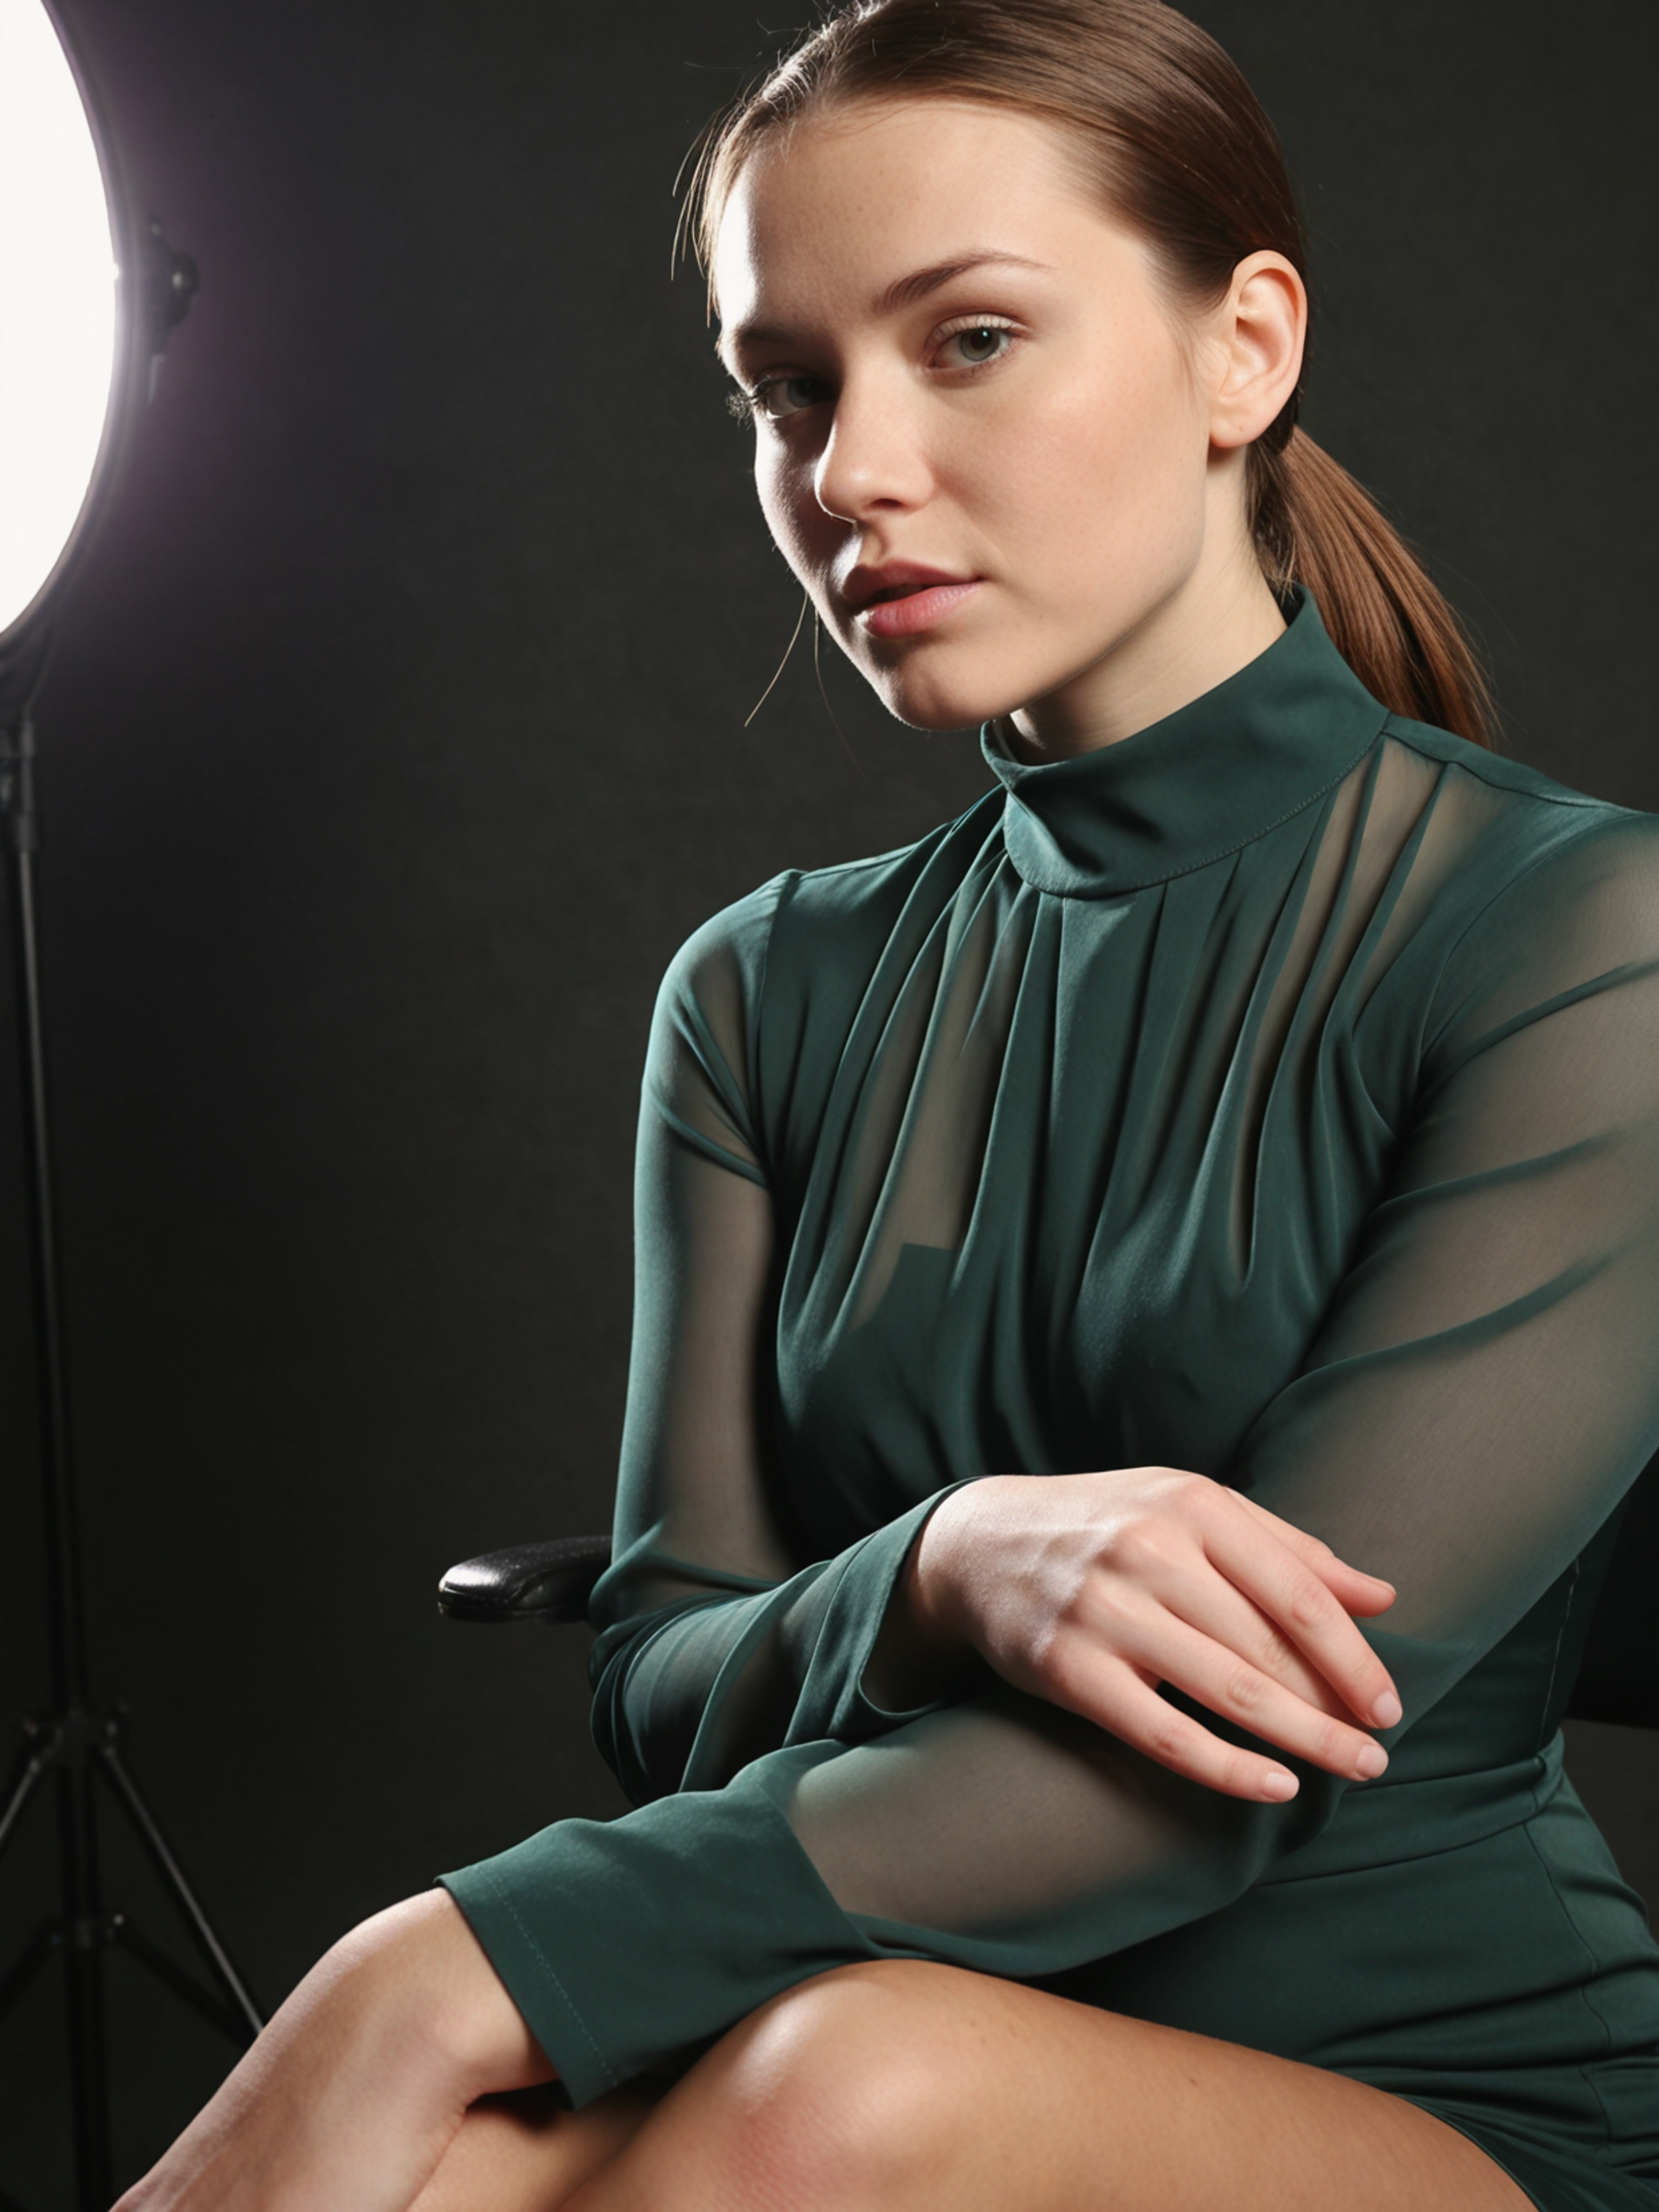
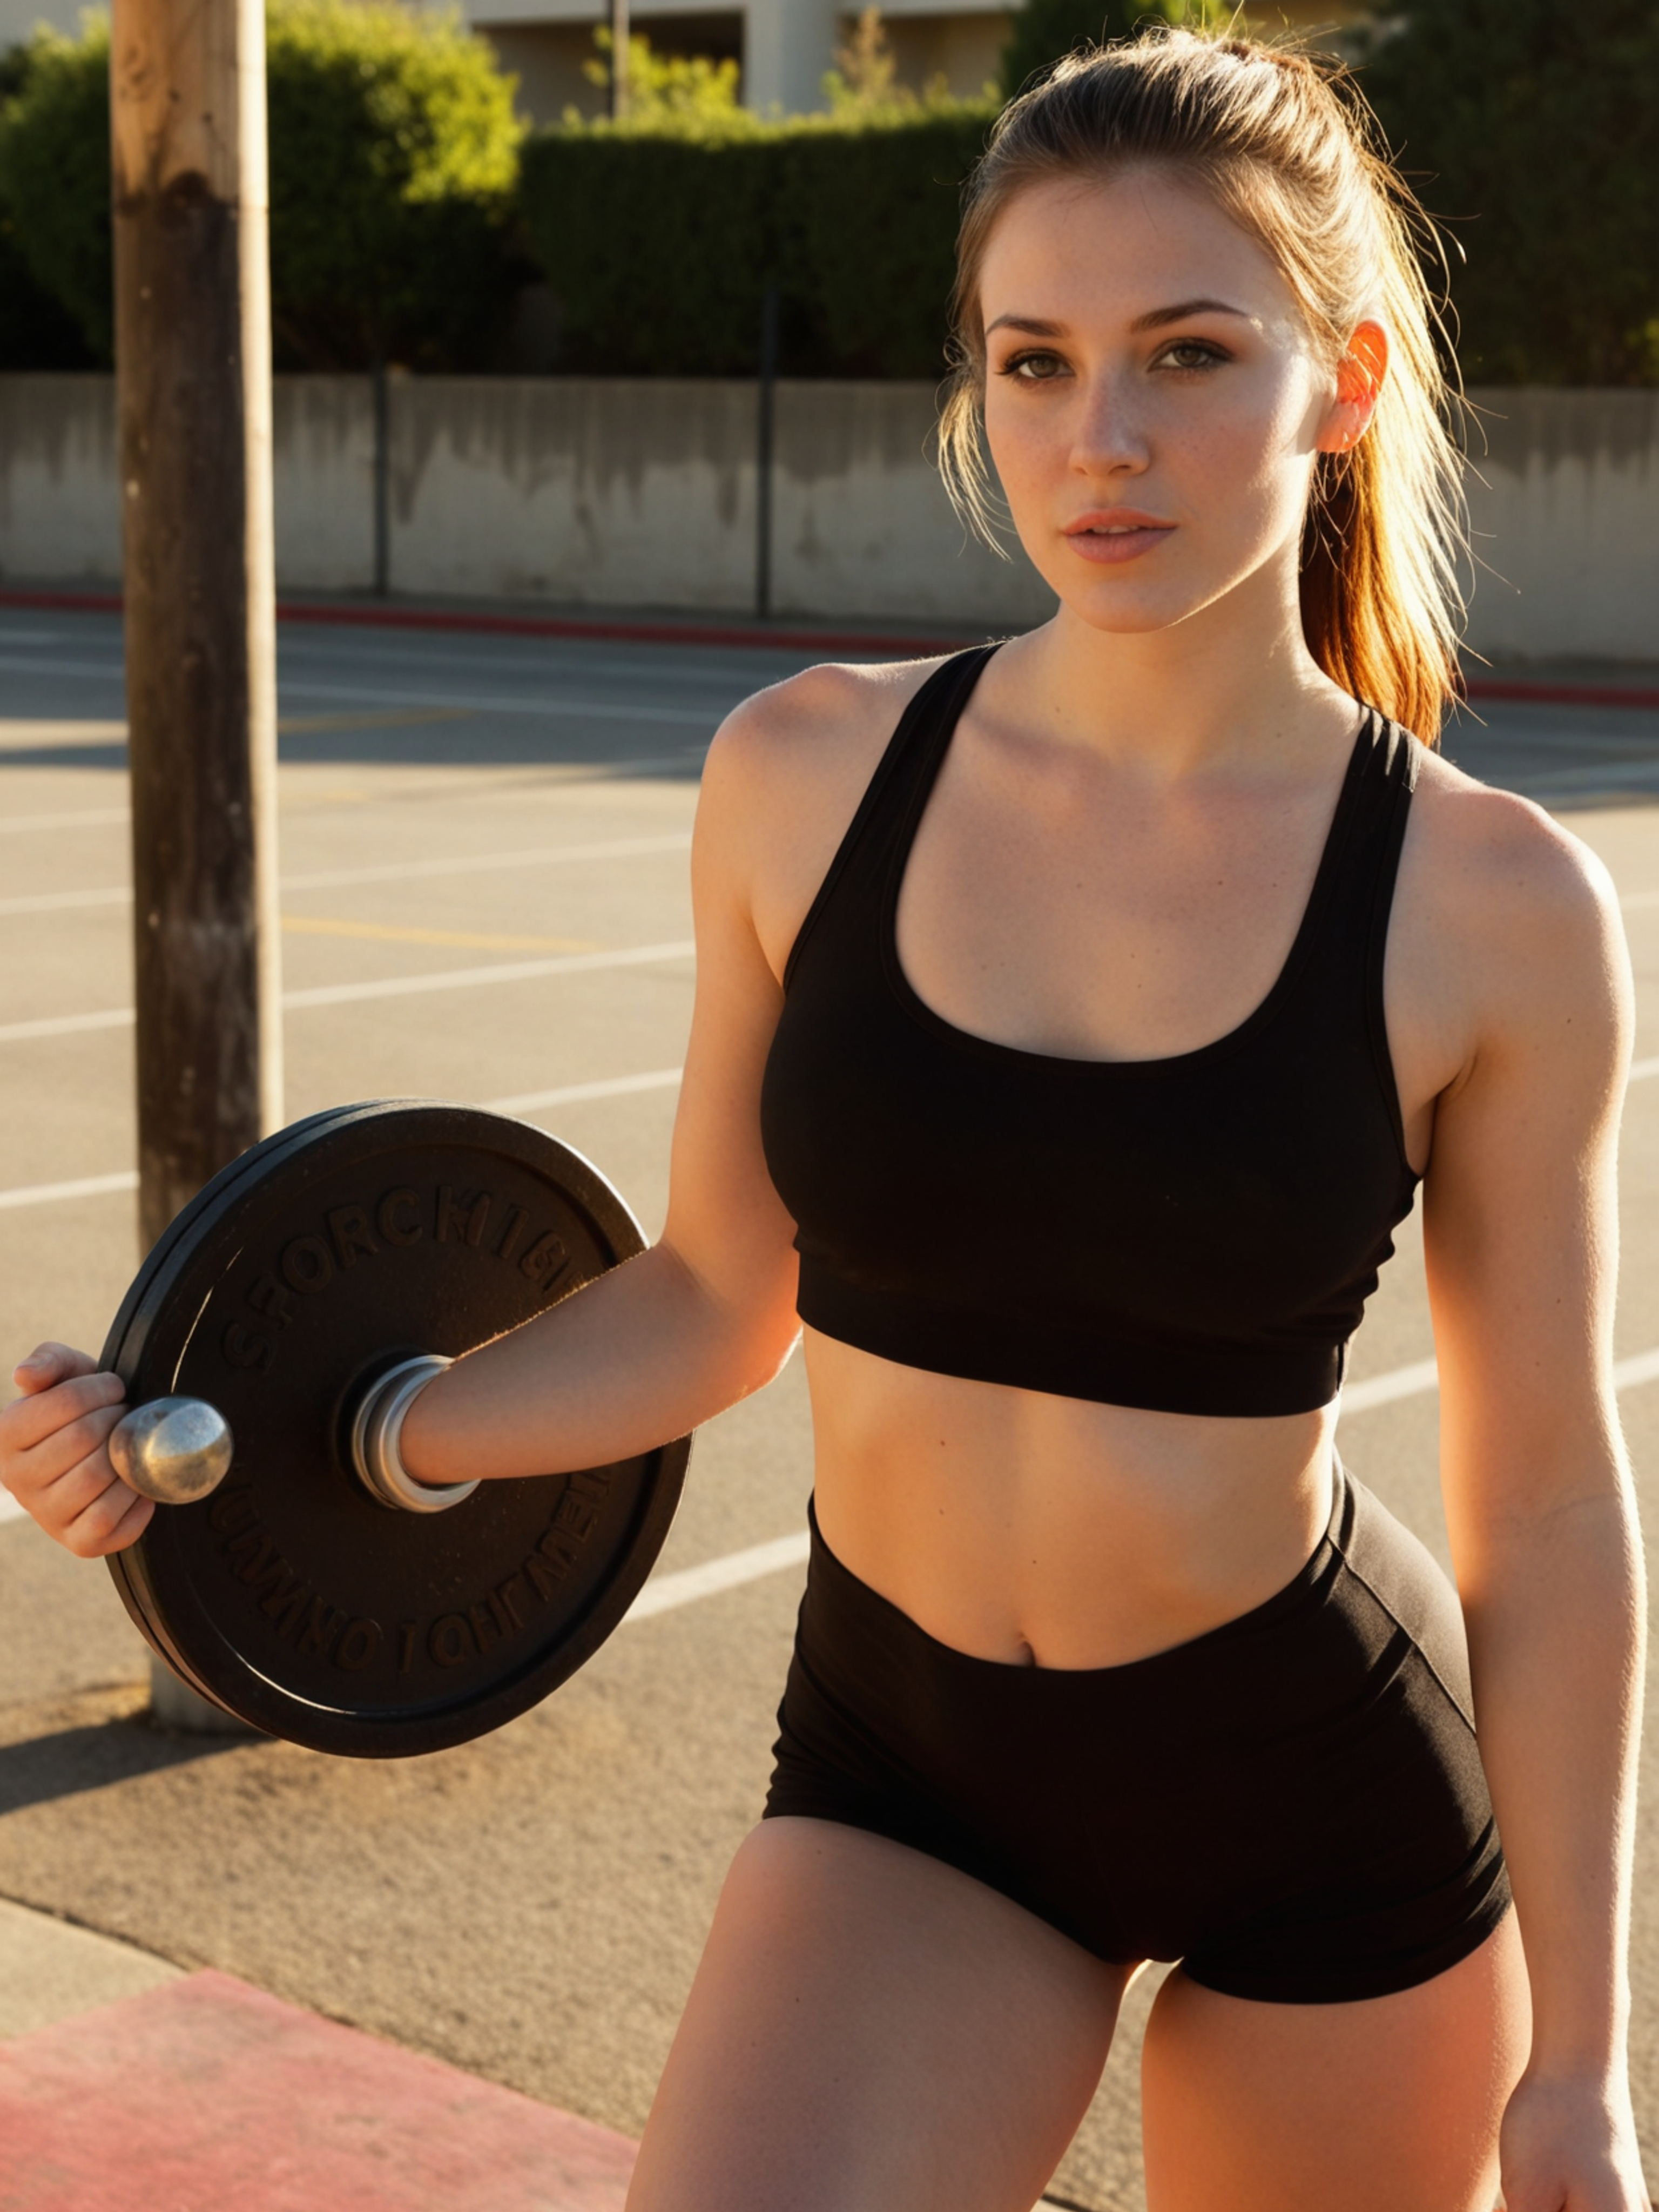
Übersicht
Warum VideoAny wählen
SDXL auf VideoAny bietet eine große LoRA-Auswahl und eignet sich für körper-, charakter- und stilbezogene Bildworkflows. Prüfen Sie Modellvariante, Credit-Bedarf und geltende Inhaltsregeln vor der Produktion.
SDXL auf VideoAny nutzt das fortschrittliche Modell von Stability AI und bietet eine umfangreiche LoRA-Bibliothek für vielfältige kreative Anforderungen. Es läuft unzensiert auf der proprietären GPU-Infrastruktur von VideoAny und ist somit unsere kostengünstigste Premium-Option zur Generierung spezifischer Körpertypen und künstlerischer Stile.
Im Gegensatz zu anderen Modellen auf VideoAny läuft SDXL direkt auf unserer eigenen GPU-Infrastruktur, wodurch Drittanbieter-APIs umgangen werden. Diese direkte Kontrolle ermöglicht eine umfassende Verwaltung der LoRA-Bibliothek und der gesamten Inferenz-Pipeline. Unsere LoRA-Sammlung für SDXL ist die umfangreichste auf der Plattform und umfasst verschiedene Körpertypen, künstlerische Stile und Charaktervorlagen, die alle für nahtloses Stapeln konzipiert sind.
Unsere Bereitstellung umfasst zwei entscheidende benutzerdefinierte Ebenen. Die DMD2 4-Schritt-Destillationspipeline beschleunigt die Generierung erheblich und erreicht Geschwindigkeiten, die mit den 30-50 Schritten von Vanilla SDXL auf lokalen GPUs vergleichbar sind. Zusätzlich verbessert die Base-to-Refiner-Pipeline die Ausgabeschärfe über das hinaus, was einstufige **VideoAny**-Bereitstellungen bieten können. Benutzer können bis zu drei LoRAs pro Generierung kombinieren, wobei jede eine einstellbare Stärke von 0,5 bis 3,0 aufweist.
Wichtige Überlegungen
- Für komplexe Prompts mit mehreren Elementen ist die SDXL-Architektur von 2023 weniger geeignet als neuere Modelle wie Flux, Qwen oder Seedream. Für komplexe Kompositionen wählen Sie Seedream 5 oder WAN 2.7 Pro.
- Das Erreichen präziser Anatomie bei hoher LoRA-Stärke kann eine Herausforderung sein. Während LoRA-Stacking Anpassungsmöglichkeiten bietet, kann es zu anatomischen Fehlern (z. B. zusätzliche Gliedmaßen, verzerrte Körperteile) führen. Für eine uneingeschränkte Körpergenerierung ohne LoRA-Modifikationen ist Flux Klein speziell für anatomische Genauigkeit konzipiert.
- Die Abhängigkeit von SDXL von der internen GPU-Flotte von VideoAny kann zu Leistungsschwankungen führen, die vom Serverzustand abhängen. Für kritische Projekte bieten Seedream 5 oder WAN 2.7, die verwaltete APIs nutzen, eine höhere Zuverlässigkeit.
- Greifen Sie über den Text-zu-Bild-Generator, den Bildeditor oder das Face-Swap-Tool auf SDXL zu.
Nutzen Sie dies als praktischen Prüfpunkt: Vergleichen Sie die Ergebnisse mit derselben Prompt, bevor Sie den Arbeitsablauf skalieren.
Modellanpassung
SDXL in Aktion
Dieser Vergleich hilft zu bestimmen, wann SDXL die optimale Wahl für Ihren kreativen Workflow ist und wann alternative Modelle besser geeignet sein könnten.
| Entscheidungsbereich | Warum es wichtig ist | Praktisches Signal | VideoAny-Aktion |
|---|---|---|---|
| Warum VideoAny wählen | Praxisrelevanz und wichtigste Entscheidungskriterien | SDXL auf VideoAny — Stability AIs Flaggschiff mit riesiger LoRA-Bibliothek, komplett unzensiert, läuft auf der eigenen GPU-Infrastruktur von VideoAny. Günstigster Premium-Ti | Verwenden Sie es, wenn dieser Kompromiss in der Produktion relevant ist. |
| Was ist VideoAny? | Praxisrelevanz und wichtigste Entscheidungskriterien | SDXL ist das einzige Modell auf VideoAny, das auf unserer eigenen GPU-Infrastruktur läuft – nicht über eine Drittanbieter-API. Diese strukturelle Entscheidung verleiht der Plattform volle c | Verwenden Sie es, wenn dieser Kompromiss in der Produktion relevant ist. |
| SDXL in Aktion erleben | Praxisrelevanz und wichtigste Entscheidungskriterien | Zwei benutzerdefinierte Schichten prägen die Bereitstellung. Die DMD2 4-Schritte-Destillationspipeline ermöglicht eine schnelle Generierung, obwohl sie auf lokalen GPUs läuft (im Vergleich zu 30–50 Schritten). | Nutzen Sie es, wenn dieser Kompromiss in der Produktion relevant ist. |
| SDXL im Vergleich zu anderen Modellen auf VideoAny | Wichtigste Erkenntnis aus dem Quellleitfaden | Auf VideoAny ist SDXL in Text-zu-Bild, im Bildeditor und in Face Swap verfügbar. Ehrliche Einordnung: Die zugrunde liegende Architektur stammt aus dem Jahr 2023 und ist nicht. | Verwenden Sie es, wenn dieser Kompromiss in der Produktion relevant ist. |
Die besten Ergebnisse erzielt man, indem man jeweils eine visuelle Aufgabe testet, anstatt mehrere Ziele in einer einzigen Anweisung zu vermischen.
Arbeitsablauf
SDXL verstehen
Eine Schritt-für-Schritt-Anleitung zur Umsetzung der Empfehlungen der Quelle für konsistente Ergebnisse auf VideoAny.
Bei VideoAny ist SDXL in unsere Tools Text-zu-Bild, Bildeditor und Gesichtstausch integriert. Es ist wichtig zu beachten, dass seine zugrunde liegende Architektur aus dem Jahr 2023 bei der Bearbeitung komplexer Multi-Element-Prompts weniger effektiv ist als neuere Modelle wie Flux, Qwen oder Seedream. Während LoRA-Stacking eine erhebliche Flexibilität bietet, kann es zu anatomischen Ungenauigkeiten wie zusätzlichen Fingern, verzerrten Gliedmaßen oder Asymmetrie führen, insbesondere wenn die LoRA-Stärken 1,5–2,0 überschreiten. Die Ausgabequalität kann auch durch den Zustand unserer ComfyUI-Flotte beeinträchtigt werden; beeinträchtigte Server können dazu führen, dass SDXL langsamer wird oder ausfällt. Obwohl die Benutzeroberfläche auf der Modellkarte "1K" anzeigen mag, handelt es sich hierbei um einen bekannten Beschriftungsfehler; die tatsächliche Ausgabeauflösung kann dynamisch bis zu 4K erreichen.
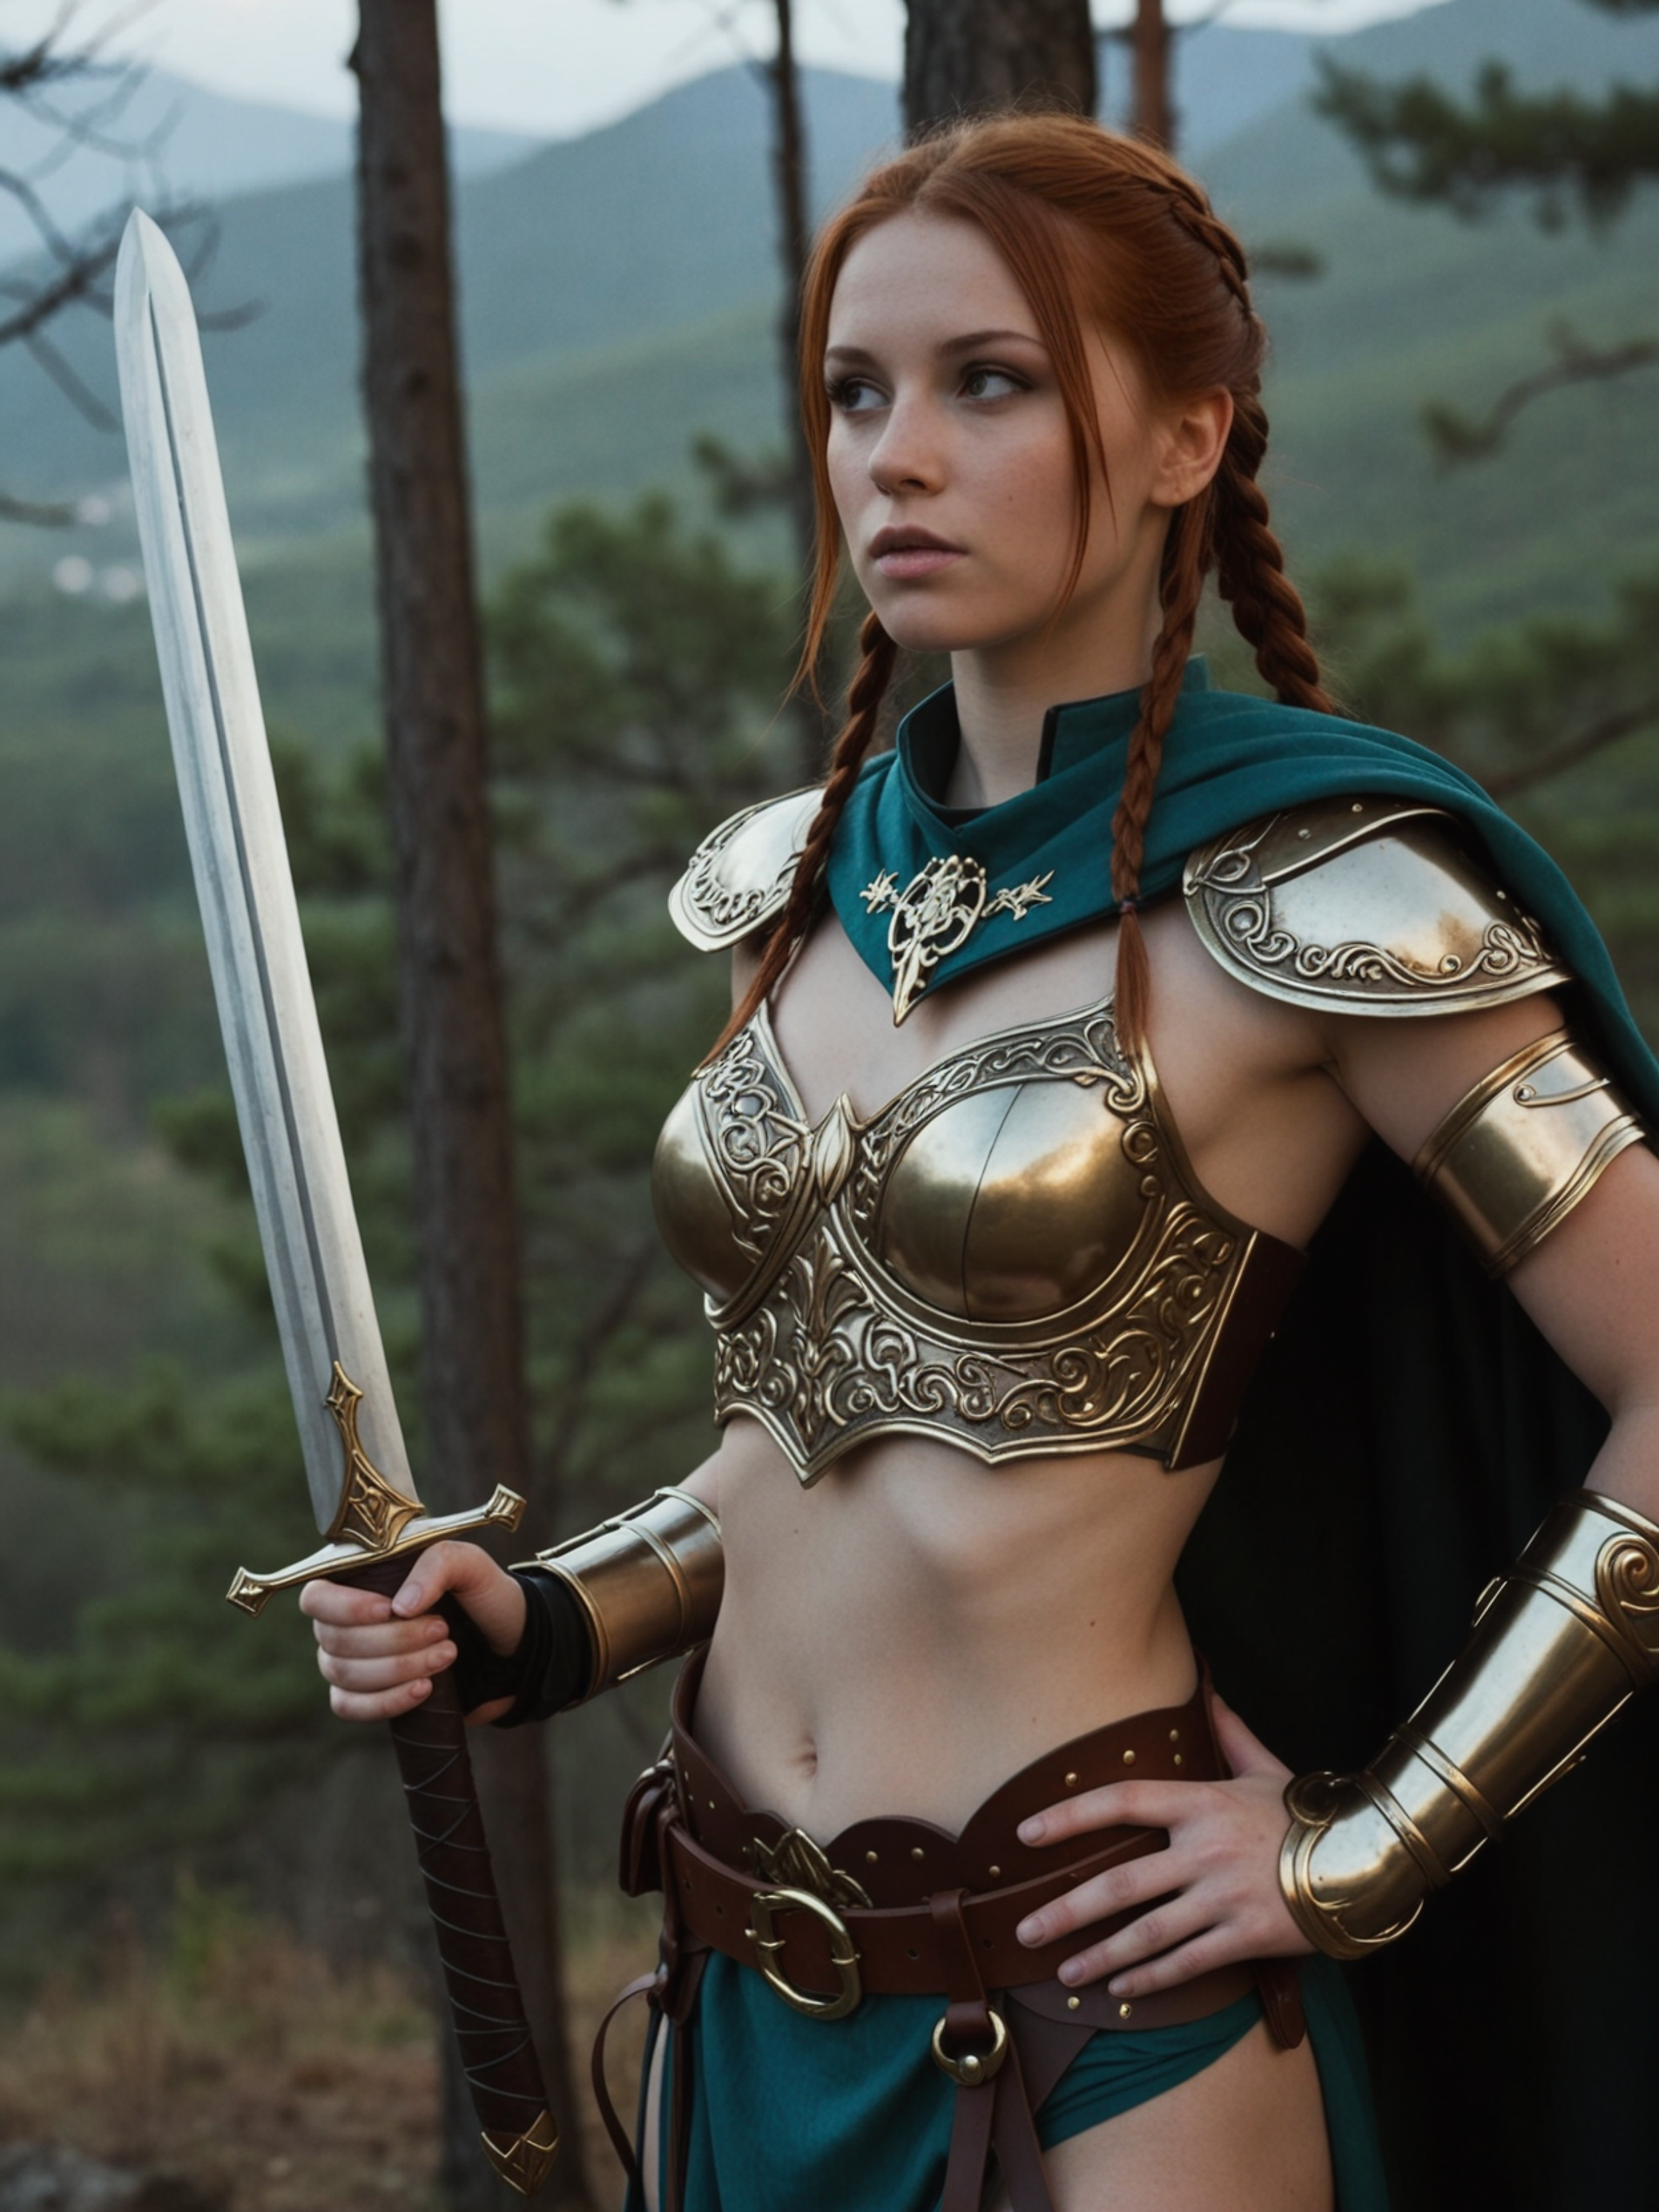
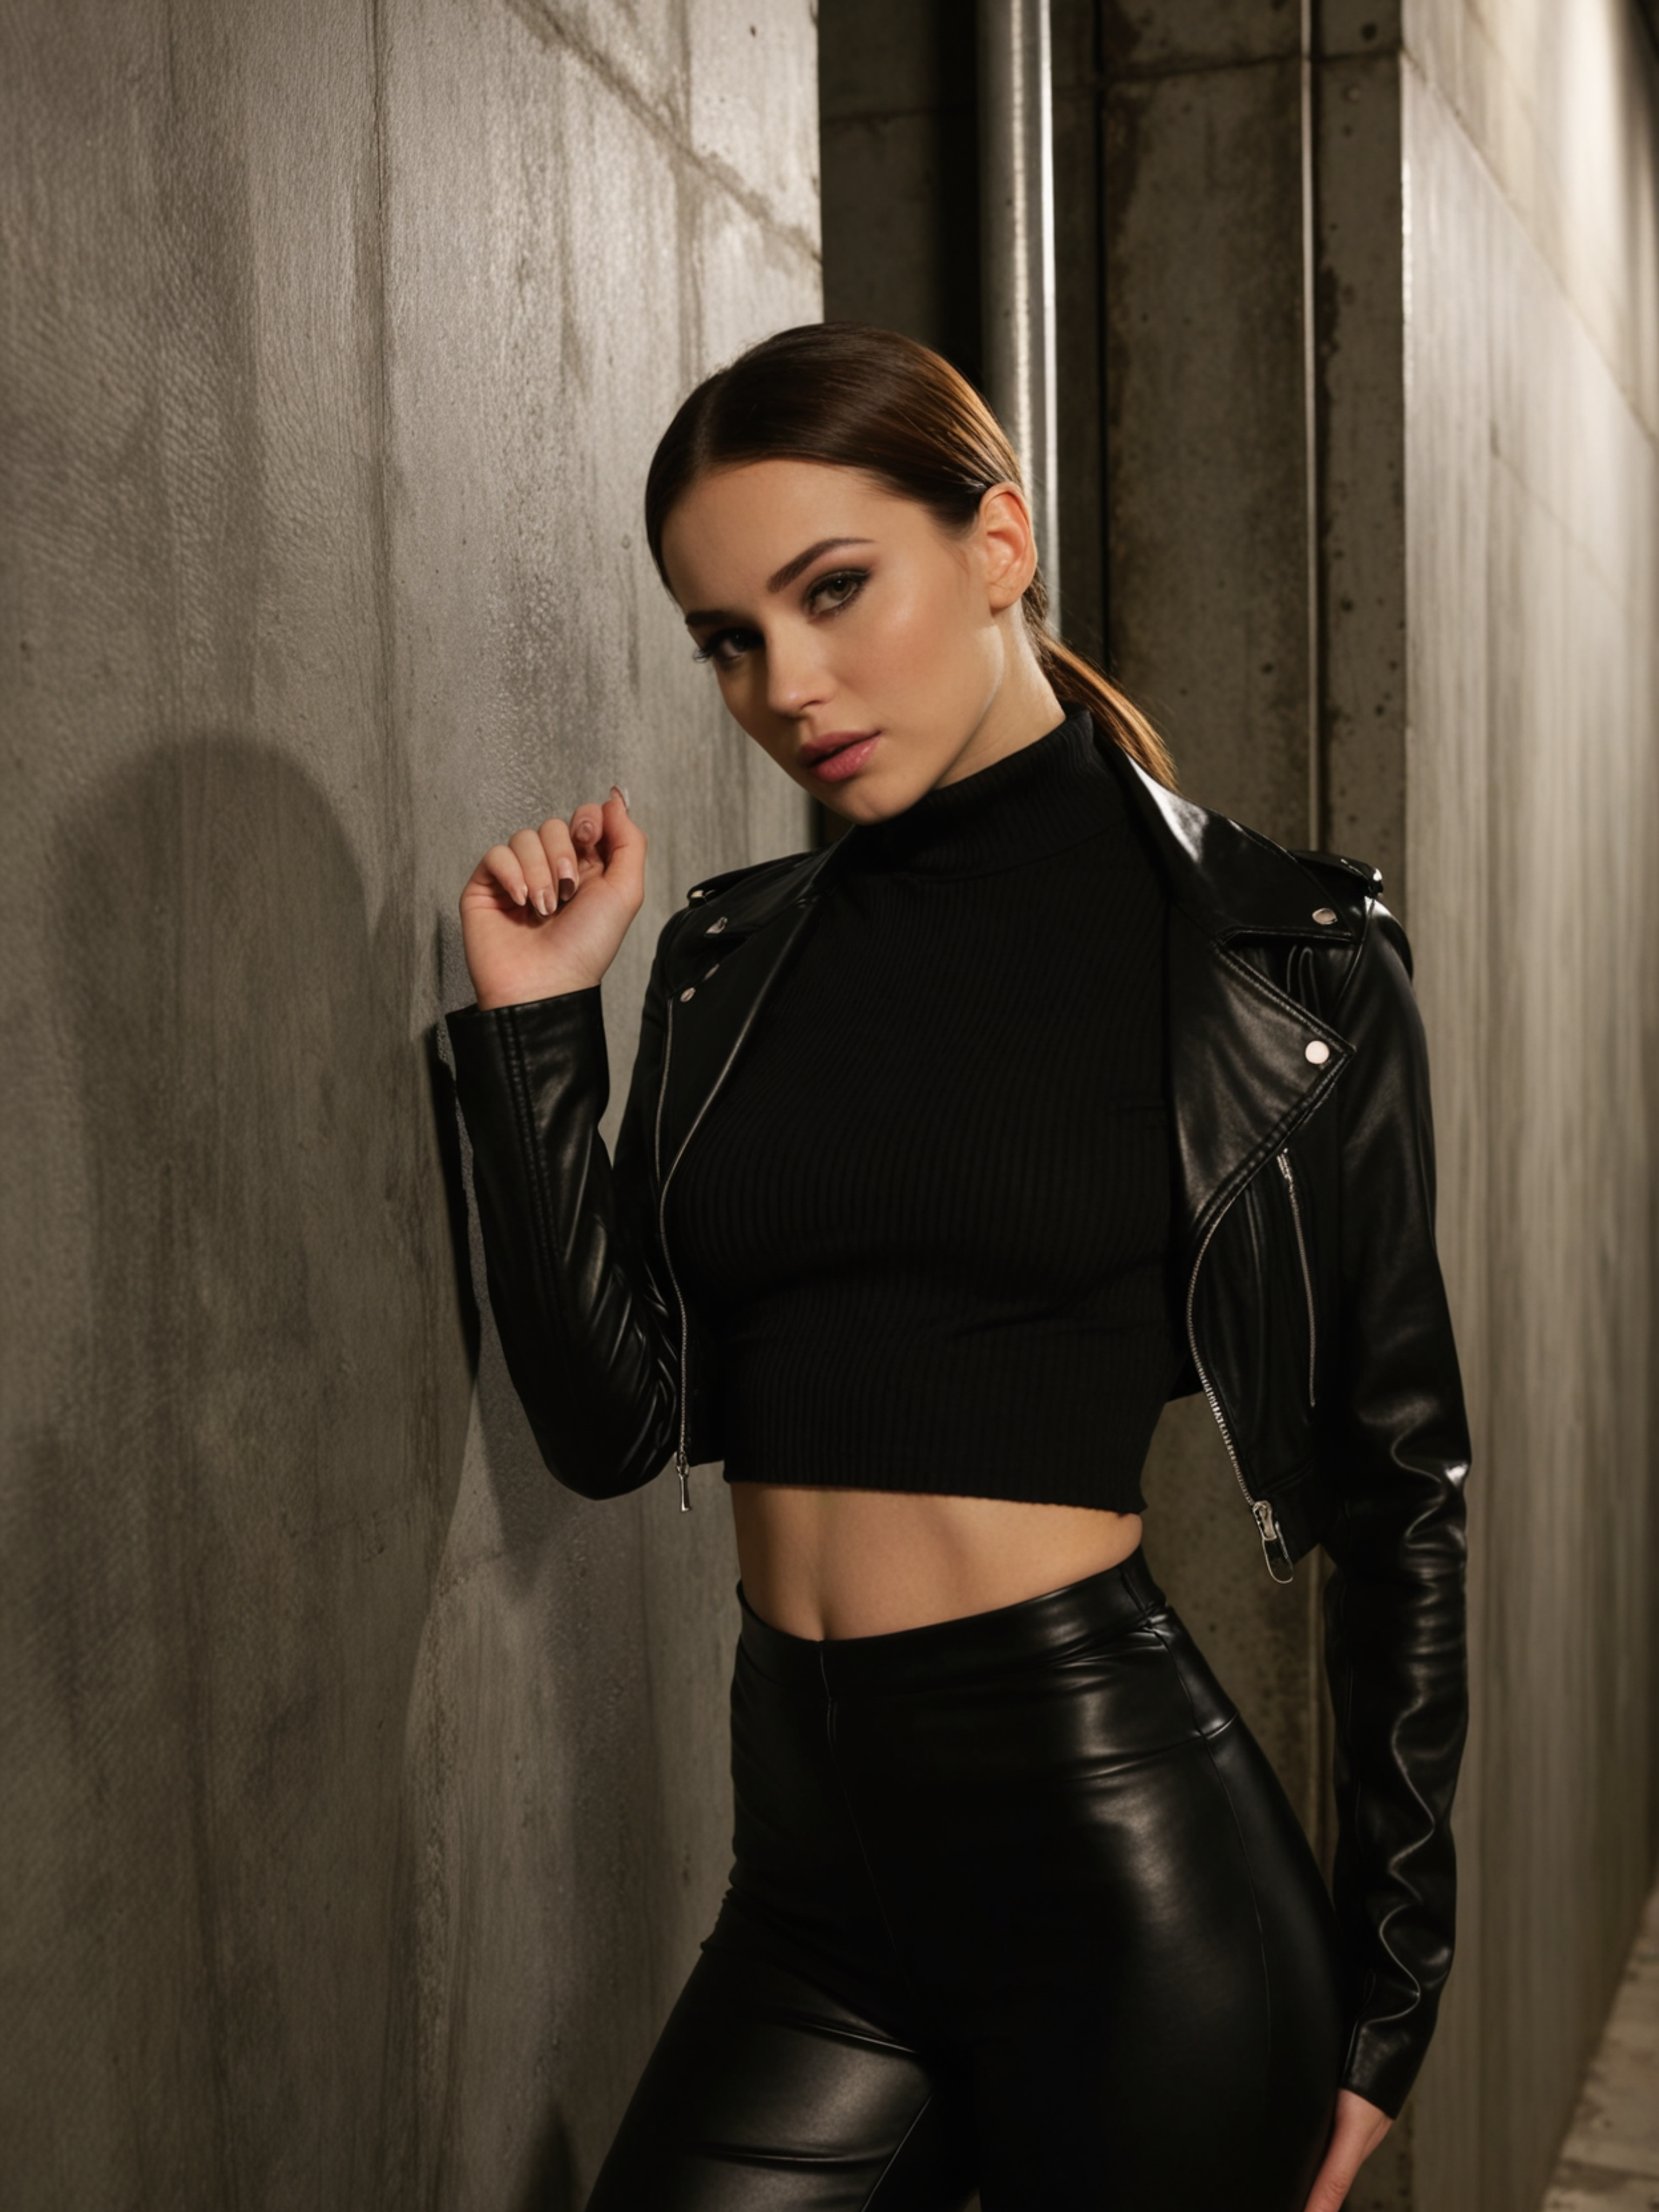
Wir stellen sechs Beispiel-Prompts mit entsprechenden Ergebnissen bereit, um Ihnen den Einstieg zu erleichtern.
Betrachten Sie diese drei Szenarien, in denen ein alternatives Modell besser geeignet sein könnte:
Hier sind fünf Strategien, die für die einzigartigen Fähigkeiten von VideoAny optimiert sind:
Produktions-Checkliste
- Wählen Sie SDXL aus den Modelloptionen.
- Formulieren Sie Ihren Prompt präzise, um Stilbeschreibungen für eine optimale LoRA-Integration klar zu definieren. Bei der Verwendung von LoRAs stellen Sie deren Stärke zwischen 0,5 und 3,0 ein, wobei Sie für erste Durchläufe mit niedrigeren Werten beginnen sollten.
- Wählen Sie Ihr gewünschtes Seitenverhältnis und die Stapelgröße aus und starten Sie dann die Generierung. Die Ausgaberesolution kann je nach Abmessungen bis zu 4K betragen.
- Offizielle SDXL 1.0 Veröffentlichungsankündigung von Stability AI: stability.ai
Kurze, prägnante Prompts sind leichter zu vergleichen als umfassende kreative Briefings.
Anwendungsfälle
SDXL im Vergleich zu anderen Modellen auf VideoAny
Diese Beispiele lassen sich in praktische Produktionsmuster für VideoAny übersetzen.
Was ist die wahre maximale Auflösung von SDXL auf VideoAny?
SDXL ist in den VideoAny-Tools Text-zu-Bild, Bildeditor und Gesichtstausch verfügbar. Seine Architektur aus dem Jahr 2023 ist im Vergleich zu Flux, Qwen oder Seedream weniger für komplexe Prompts mit mehreren Elementen geeignet.
Wichtige Überlegungen
- Passen Sie die Modellauswahl an die spezifische visuelle Aufgabe an.
- Halten Sie Prompts prägnant, konkret und testbar.
- Priorisieren Sie die Überprüfung von Identität, Beleuchtung, Anatomie und Text, bevor Sie die Größe anpassen.
- Nutzen Sie die Nachbearbeitungstools von VideoAny für Bewegungs- oder Bearbeitungsanforderungen.
- Pricing model
- Die benötigten Credits hängen vom gewählten Modell und den Ausgabeeinstellungen ab.
- Trade-offs
- Die Ausgabequalität hängt weiterhin von der Klarheit des Prompts, der Qualität des Quellbildes und dem Iterationsbudget ab.
- Best fit
- Ersteller, die konsistente KI-Visuals wünschen, ohne für jedes Asset neue Workflows einrichten zu müssen.
Wie viele LoRAs können gleichzeitig gestapelt werden?
Sechs Prompts, sechs Ergebnisse. Kopieren Sie einen beliebigen Prompt, um vom selben Ausgangspunkt zu beginnen.
Wichtige Überlegungen
- Passen Sie die Modellauswahl an die jeweilige visuelle Aufgabe an.
- Halten Sie Prompts prägnant, konkret und testbar.
- Priorisieren Sie die Überprüfung von Identität, Beleuchtung, Anatomie und Text, bevor Sie skalieren.
- Nutzen Sie die Nachbearbeitungstools von VideoAny für Bewegungs- oder Bearbeitungsanforderungen.
- Pricing model
- Die benötigten Credits hängen vom gewählten Modell und den Ausgabeeinstellungen ab.
- Trade-offs
- Die Ausgabequalität hängt weiterhin von der Klarheit des Prompts, der Qualität des Quellbildes und dem Iterationsbudget ab.
- Best fit
- Kreatoren, die konsistente KI-Visuals wünschen, ohne für jedes Asset neue Arbeitsabläufe etablieren zu müssen.
Warum erzeugt VideoAny manchmal anatomische Fehler?
Drei Kategorien, in denen ein anderes Modell besser passt:
Wichtige Überlegungen
- Passen Sie die Modellauswahl an die spezifische visuelle Aufgabe an.
- Halten Sie Prompts prägnant, konkret und testbar.
- Priorisieren Sie die Überprüfung von Identität, Beleuchtung, Anatomie und Text, bevor Sie skalieren.
- Nutzen Sie die Nachbearbeitungstools von VideoAny für Bewegungs- oder Bearbeitungsanforderungen.
- Pricing model
- Die benötigten Credits hängen vom gewählten Modell und den Ausgabeeinstellungen ab.
- Trade-offs
- Die Ausgabequalität hängt weiterhin von der Klarheit des Prompts, der Qualität des Quellbildes und dem Iterationsbudget ab.
- Best fit
- Ersteller, die konsistente KI-Visuals wünschen, ohne für jedes Asset neue Workflows einrichten zu müssen.
Was ist die DMD2-Destillation?
Fünf auf die Spezialitäten von VideoAny abgestimmte Taktiken:
Wichtige Überlegungen
- Passen Sie die Modellauswahl an die jeweilige visuelle Aufgabe an.
- Halten Sie Prompts prägnant, konkret und testbar.
- Priorisieren Sie die Überprüfung von Identität, Beleuchtung, Anatomie und Text, bevor Sie skalieren.
- Nutzen Sie die Nachbearbeitungstools von VideoAny für Bewegungs- oder Bearbeitungsanforderungen.
- Pricing model
- Die benötigten Credits hängen vom gewählten Modell und den Ausgabeeinstellungen ab.
- Trade-offs
- Die Ausgabequalität hängt weiterhin von der Klarheit des Prompts, der Qualität des Quellbildes und dem Iterationsbudget ab.
- Best fit
- Ersteller, die konsistente KI-Visuals wünschen, ohne für jedes Asset neue Arbeitsabläufe etablieren zu müssen.
Häufig gestellte Fragen (FAQ)
Häufig gestellte Fragen zu diesem Workflow
Was ist die tatsächliche maximale Auflösung für SDXL auf VideoAny?
SDXL kann Bilder dynamisch bis zu 4K (4096 px an der längsten Seite) generieren. Die in der Benutzeroberfläche manchmal angezeigte Bezeichnung "1K" ist ein bekannter visueller Fehler und spiegelt nicht die tatsächliche Ausgabefähigkeit wider.
Wie viele LoRAs kann ich in einer einzigen Generierung kombinieren?
Sie können pro Generierung bis zu drei LoRAs stapeln, wobei jede eine unabhängige Stärkeeinstellung von 0,5 bis 3,0 hat. Für erste Durchläufe wird empfohlen, mit niedrigeren Stärken (0,5–1,5) zu beginnen, da höhere Stärken die anatomische Genauigkeit zugunsten eines stärkeren stilistischen Einflusses beeinträchtigen können.
Warum erzeugt VideoAny gelegentlich anatomische Fehler?
Dafür gibt es zwei Hauptgründe: Erstens ist die Architektur von SDXL aus dem Jahr 2023 weniger fortschrittlich als die neuerer Modelle wie Flux, Qwen oder Seedream, die von Natur aus anatomische Details präziser verarbeiten. Zweitens opfert die Verwendung hoher LoRA-Stärken (über 1,5–2,0) oft die anatomische Korrektheit zugunsten eines ausgeprägteren stilistischen Effekts. Für eine durchweg präzise Anatomie sollten Sie Flux Klein in Betracht ziehen.
Was ist die DMD2-Destillation?
Die DMD2-Destillation ist eine maßgeschneiderte 4-Schritt-Pipeline, die es SDXL ermöglicht, Bilder schnell auf lokalen GPUs zu generieren. Während das Standard-SDXL typischerweise 30–50 Inferenzschritte benötigt, erreicht die VideoAny-Variante eine vergleichbare Qualität in nur 4 Schritten. Geringfügige Detailverluste durch diese Beschleunigung werden durch die nachfolgende Refiner-Pipeline kompensiert.
Was ist die Refiner-Pipeline?
SDXL nutzt eine zweistufige Architektur: Das Basismodell generiert zunächst vorläufige latente Bilder, und anschließend führt ein spezialisiertes Verfeinerungsmodell die finalen Entrauschungsschritte durch, um Details und Schärfe zu verbessern. Die Implementierung von VideoAny integriert beide Stufen in einen einzigen Aufruf, wodurch die Qualitätsvorteile erzielt werden, ohne dass Benutzer einen separaten zweistufigen Workflow verwalten müssen.
Warum schlagen meine SDXL-Generierungen manchmal fehl oder verlangsamen sich?
SDXL läuft auf der dedizierten GPU-Flotte von VideoAny und nicht über eine von Dritten verwaltete API. Folglich kann die Leistung von SDXL beeinträchtigt werden, wenn unsere ComfyUI-Flotte Probleme hat. Für Workflows, bei denen Zuverlässigkeit oberste Priorität hat, bieten Seedream 5 und WAN 2.7, die verwaltete APIs nutzen, eine konsistentere Leistung bei Infrastrukturproblemen.
Erstellen
Erstellen Sie einen SDXL – Unzensierte KI-Bildgenerierung mit LoRA-Stacking auf VideoAny-Workflow in VideoAny
Nutzen Sie diese Modellrichtlinie als Ausgangspunkt, um dann alles innerhalb des integrierten VideoAny-Workflows zu generieren, zu bearbeiten, zu animieren und zu veröffentlichen.
- Bilder aus präzisen Prompts generieren
- Verwandeln Sie Standbilder in Videos
- Wiederholbare Einstellungen für zukünftige Batches speichern